vLLM 社区开源的全模态推理框架,覆盖文本、图像、音频、视频与动作
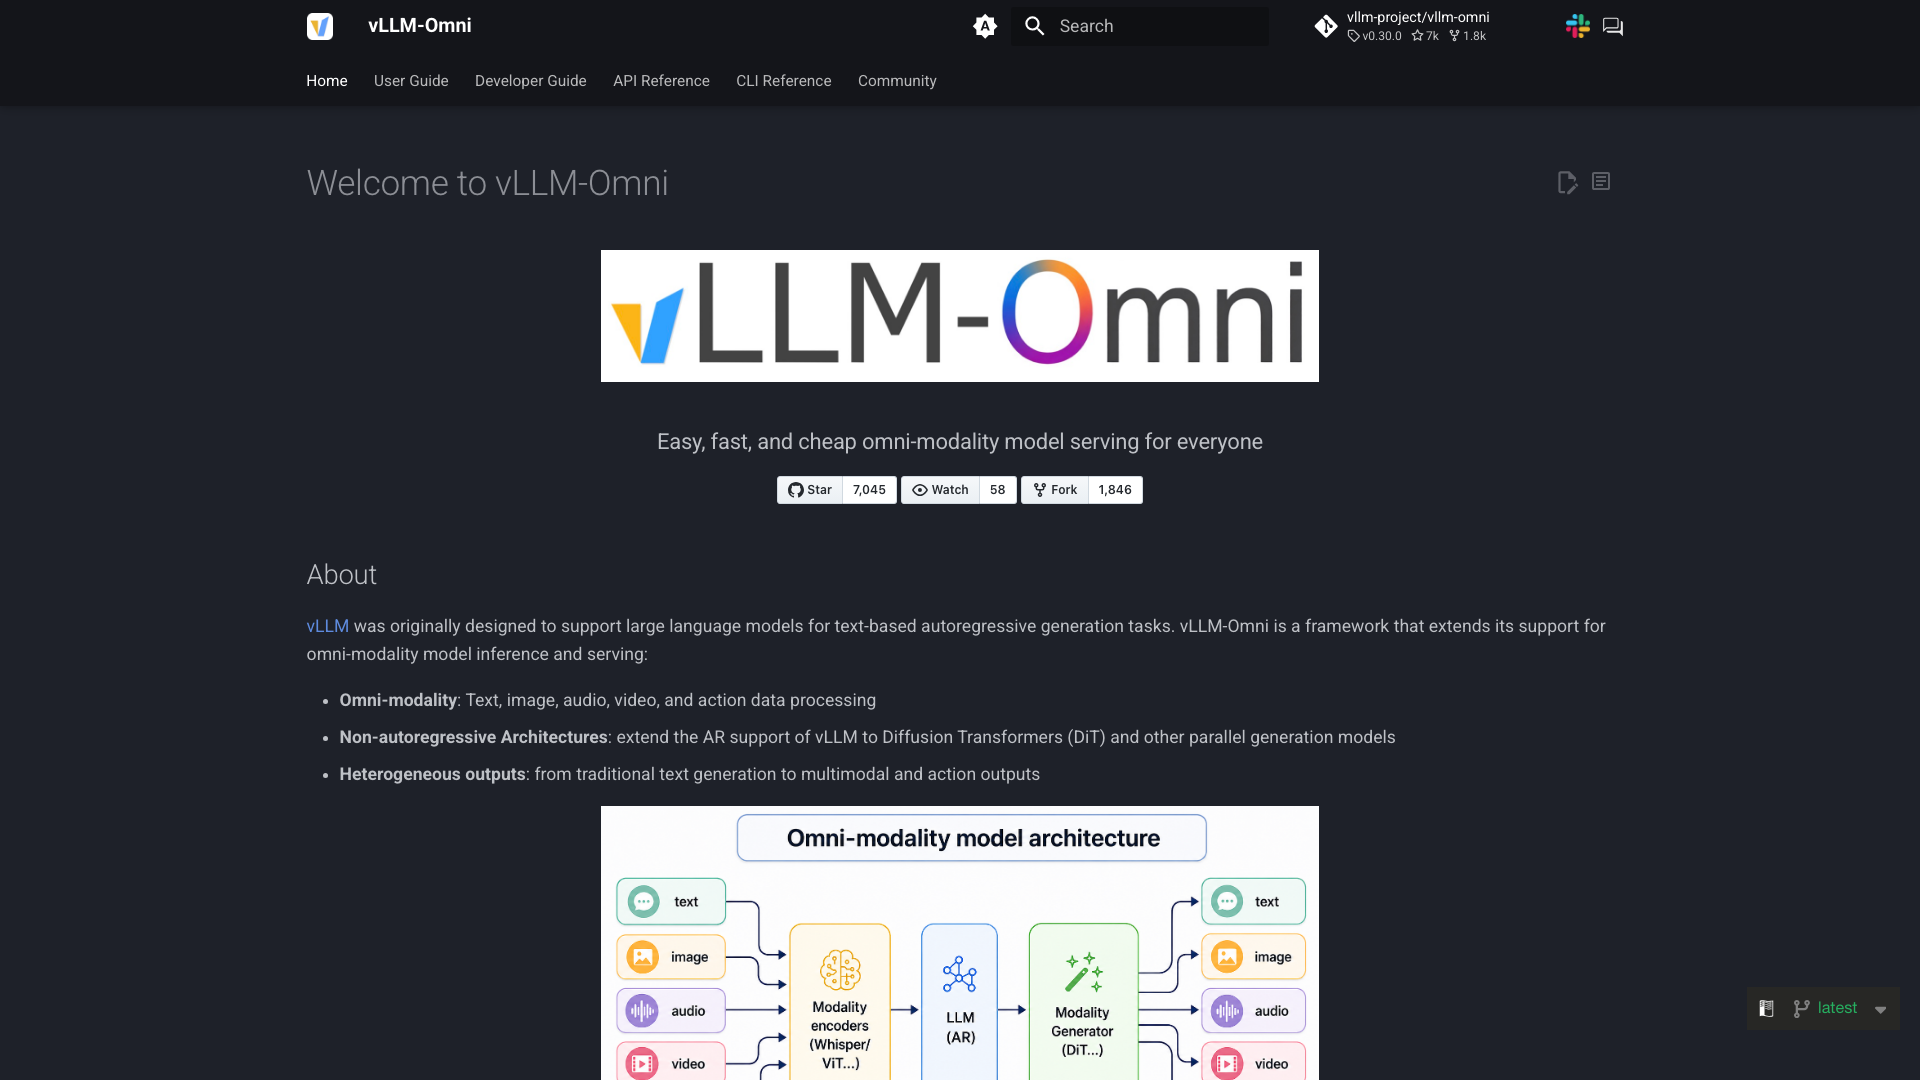
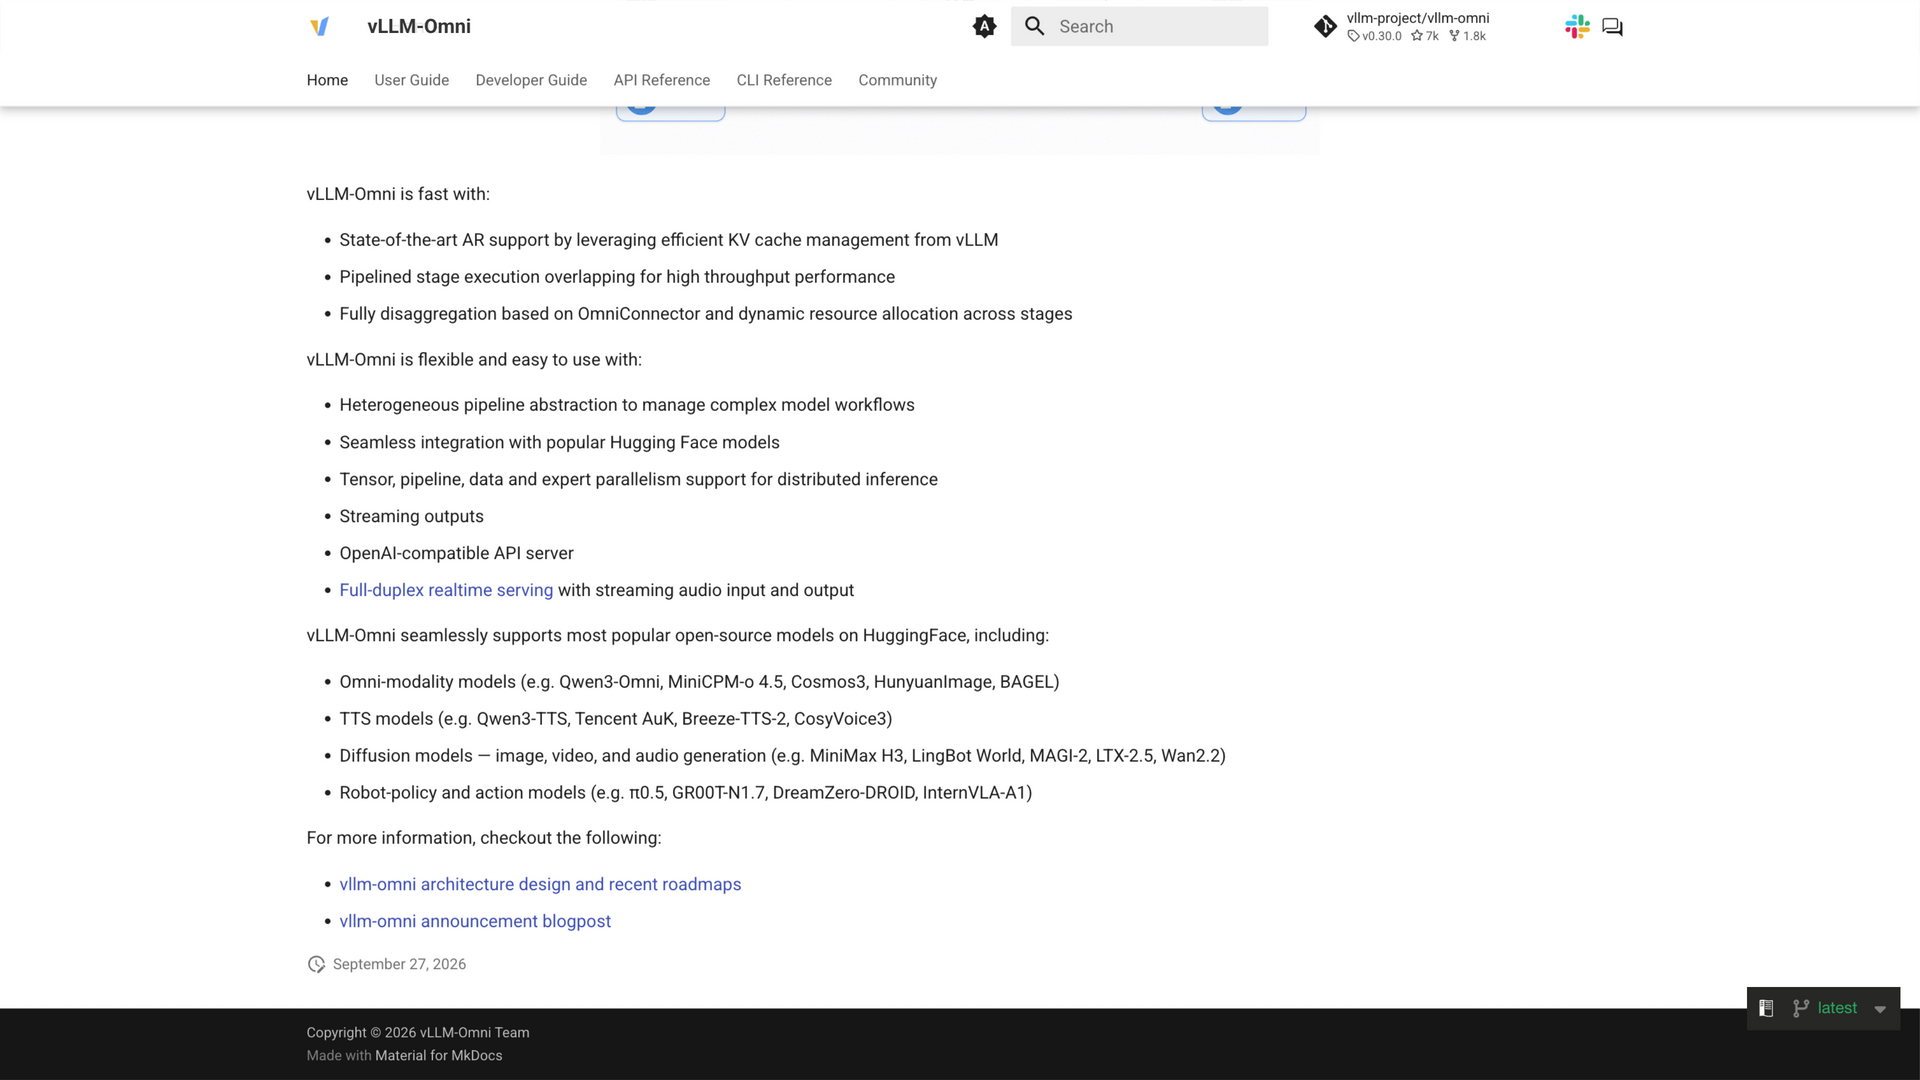
vLLM-Omni 是 vLLM 社区 2025 年 11 月发布的全模态推理与服务 框架,官网标语 "Easy, fast, and cheap omni-modality model serving for everyone"。在 vLLM 文本自回归能力之上处理文本、图像、音频、 视频与动作数据,并将推理支持扩展到 Diffusion Transformers(DiT) 等并行生成架构,提供 OpenAI 兼容 API server、流式输出与流式音频 输入输出的实时全双工服务。集成 HuggingFace 上的主流开源模型,覆盖 全模态(Qwen3-Omni、MiniCPM-o 4.5)、TTS(Qwen3-TTS、CosyVoice3)、 扩散生成(MiniMax H3、Wan2.2)与机器人策略(π0.5、GR00T-N1.7) 等类别。Apache-2.0 开源自部署,当前 v0.30.0 跟随 vLLM 偶数版本 发布,GitHub 7,045 星(2026-10-05)。
暂无相关文章。