高吞吐、省显存的 LLM 推理与服务引擎,Apache-2.0 开源
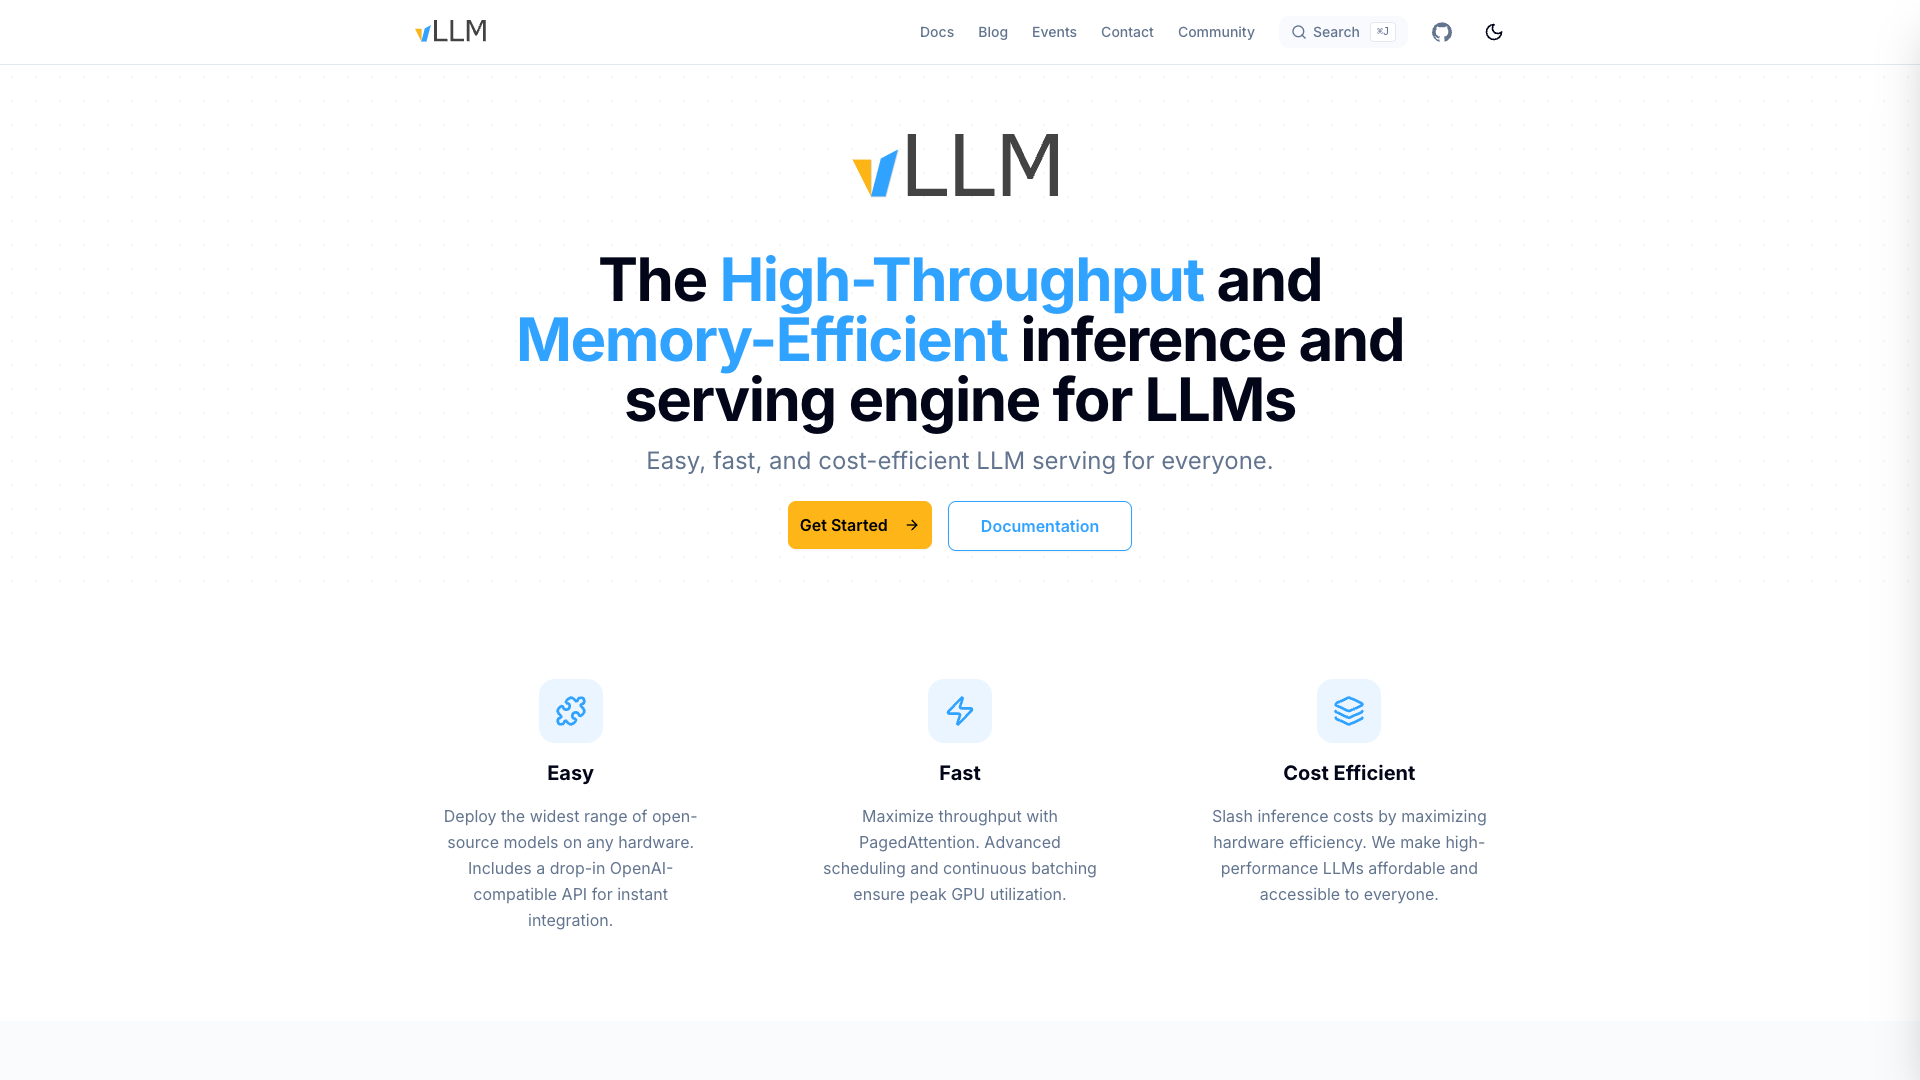
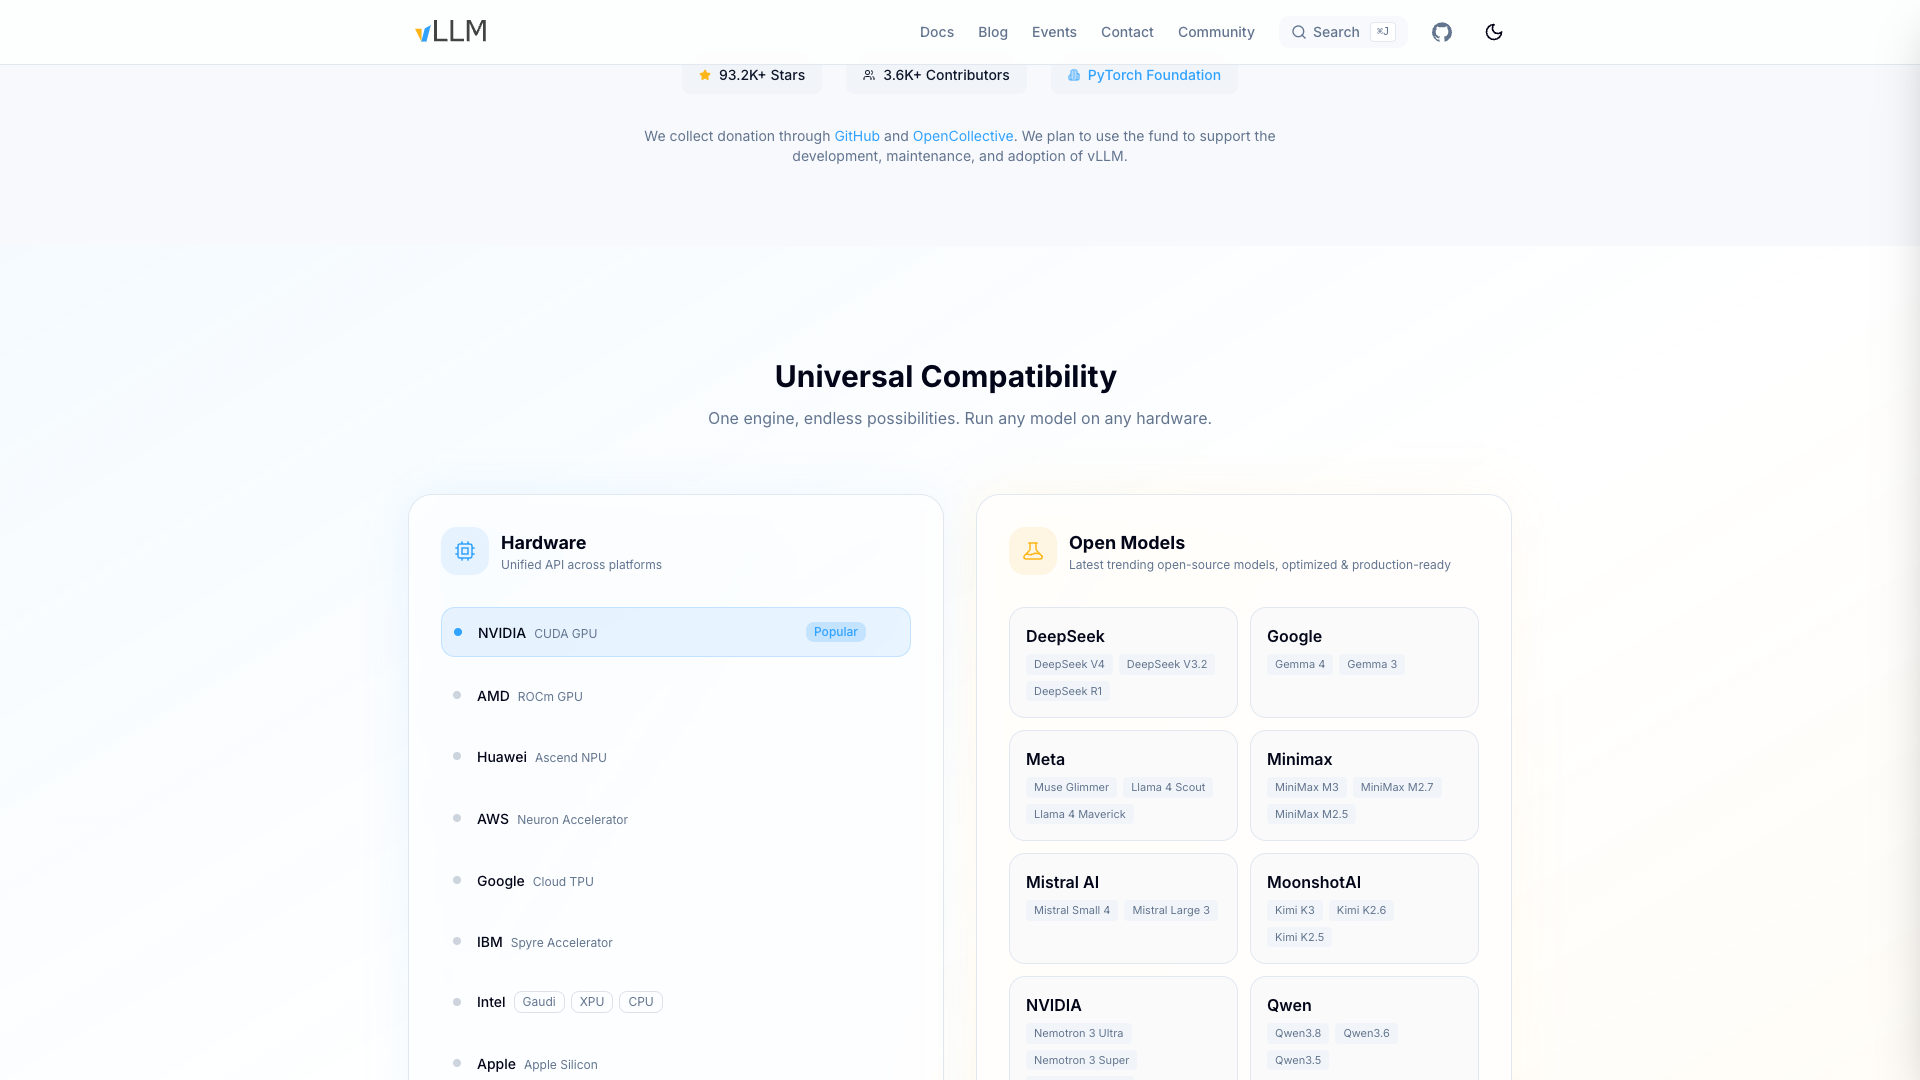
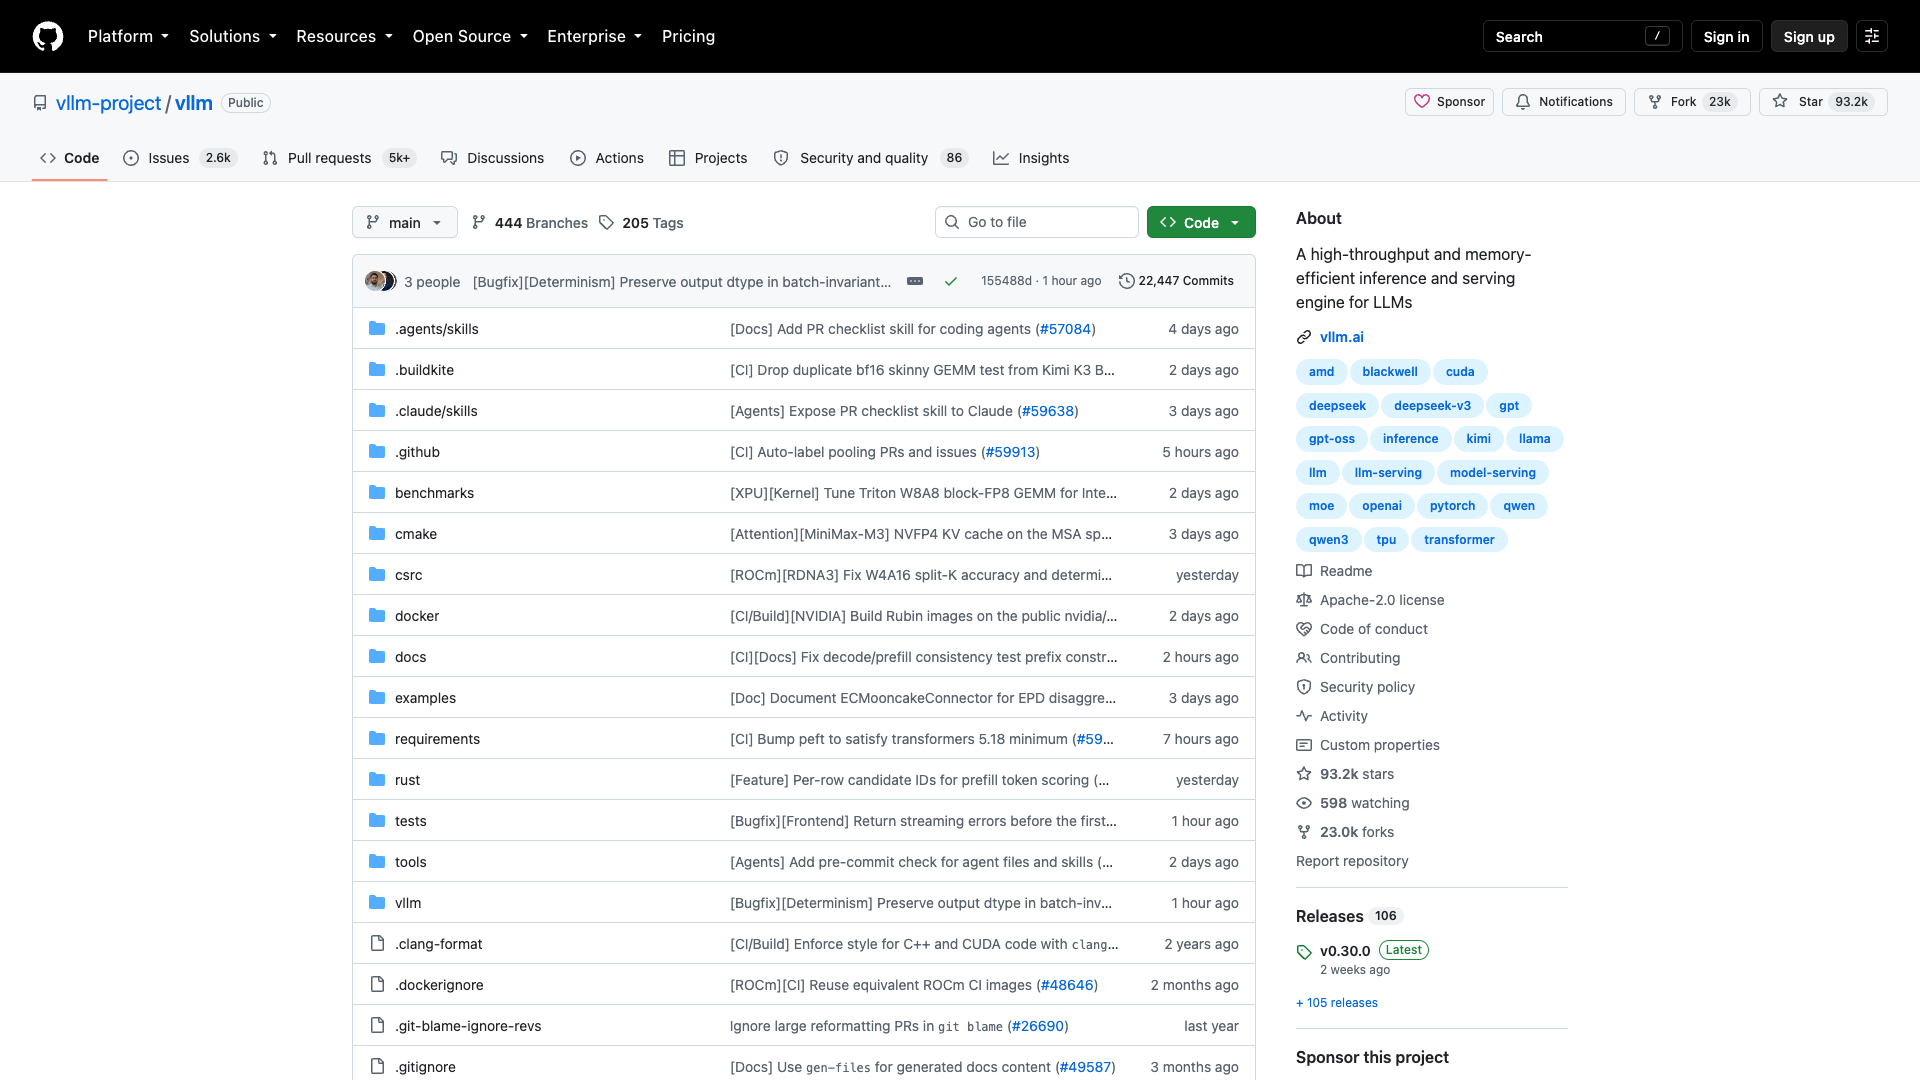
vLLM 以 PagedAttention 与连续批处理提升推理吞吐和 GPU 利用率,官网标语 "Easy, fast, and cost-efficient LLM serving for everyone."。提供 OpenAI 兼容 API,可在 NVIDIA、AMD、昇腾、 TPU、Apple Silicon 等硬件上部署 DeepSeek、Qwen、Kimi、GLM、 Llama 4 等开源模型,支持 pip/uv/Docker 安装,当前 stable v0.30.0(2026-10-05)。Apache-2.0 开源协议,GitHub 93.2K+ Stars(2026-10-05)。
暂无相关文章。