开源的 LLM 与多模态推理服务框架,从单卡到分布式集群部署
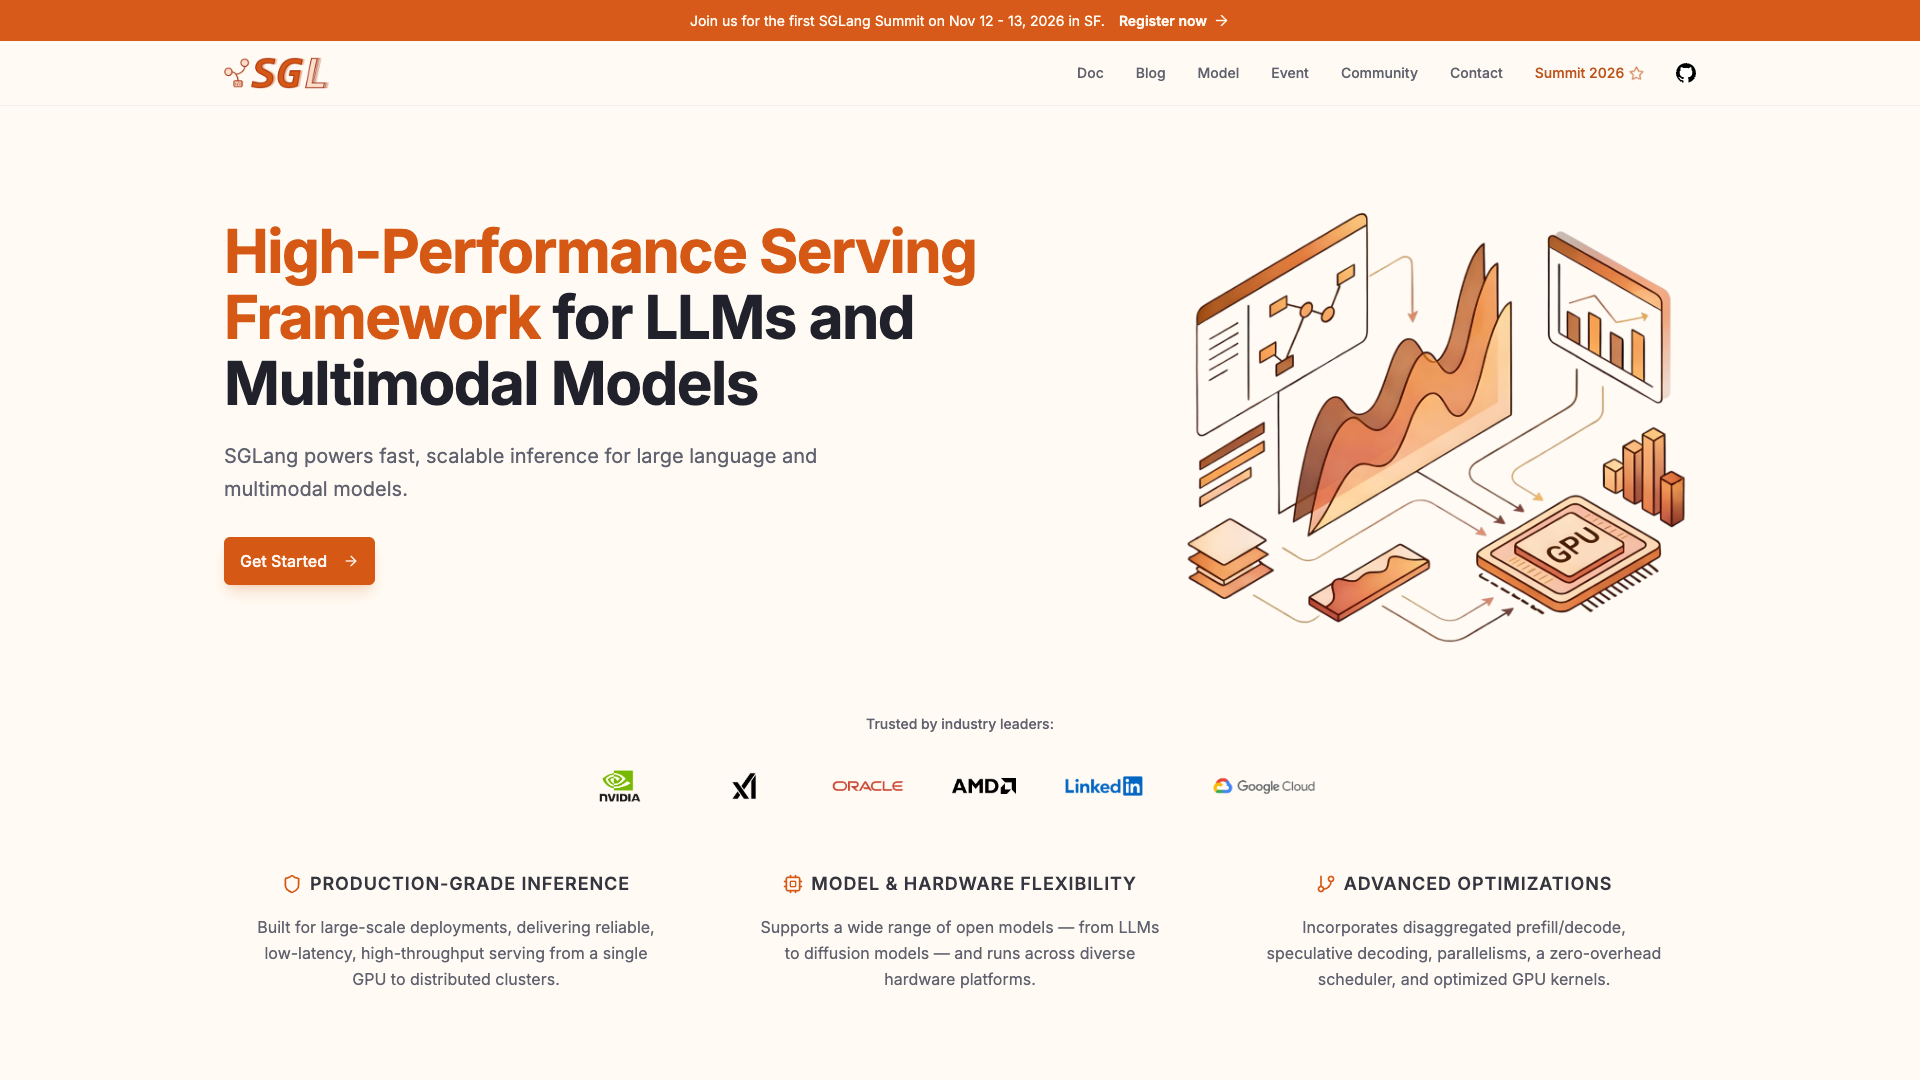
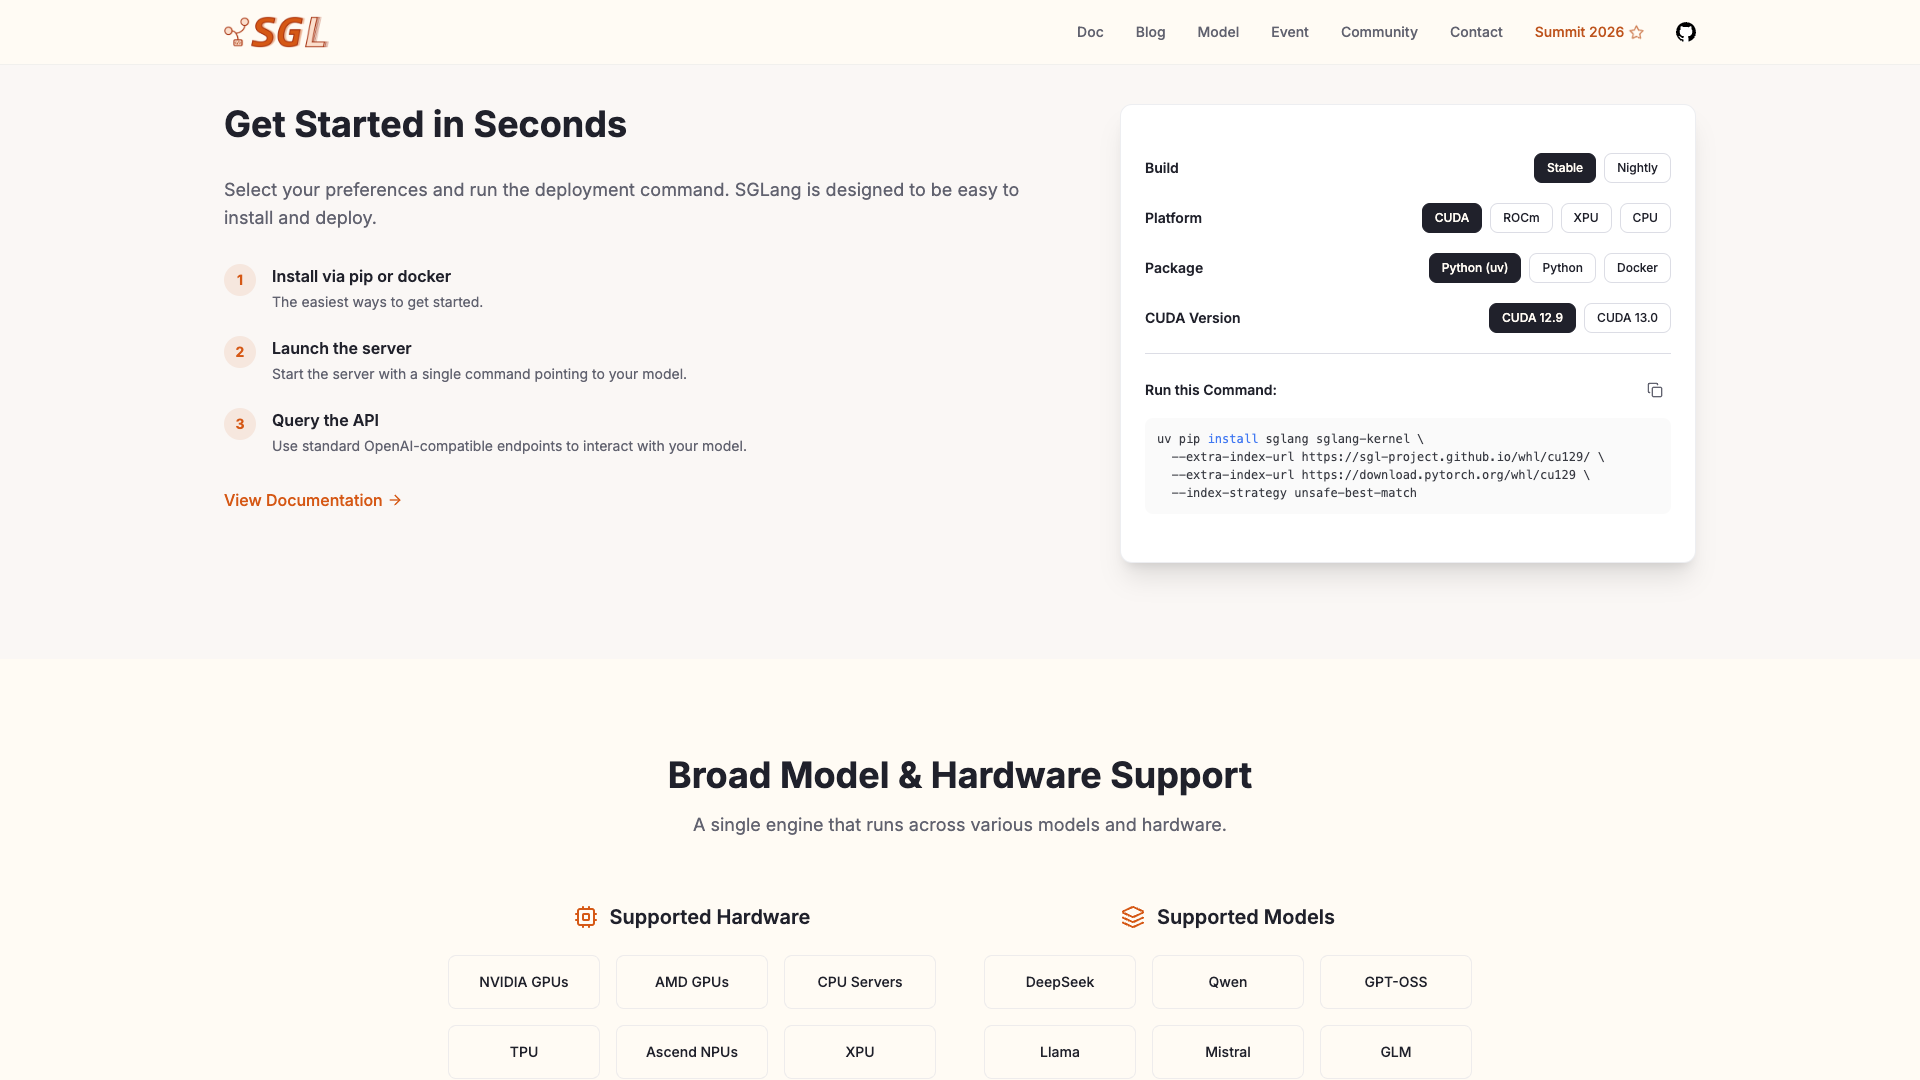
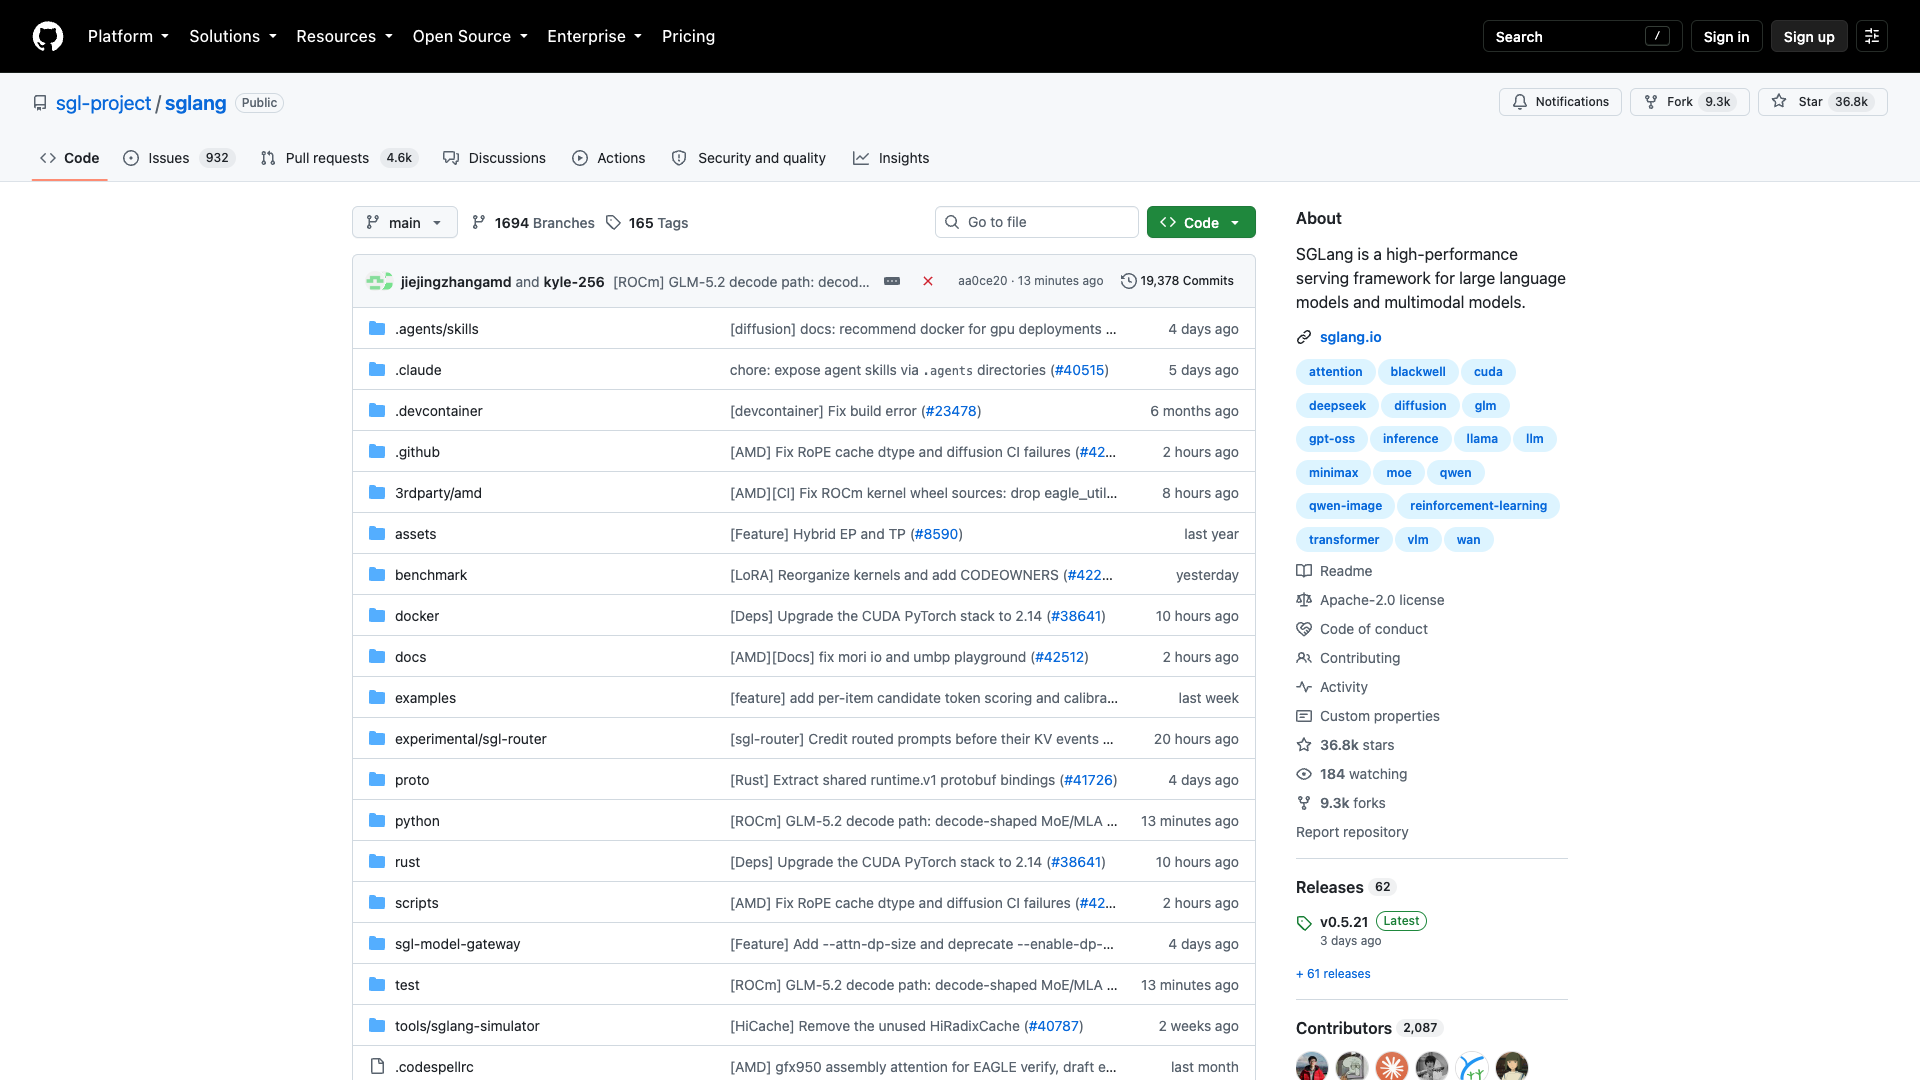
SGLang 是 Apache-2.0 开源的 LLM 与多模态推理服务框架,官网标语 "powers fast, scalable inference for large language and multimodal models."。pip/uv/Docker 安装、一条命令指向模型即可启动服务,对外提供标准 OpenAI 兼容端点;支持 DeepSeek、Qwen、GPT-OSS、Llama、Mistral、GLM 等模型, 可运行在 NVIDIA/AMD GPU、TPU、Ascend NPU、XPU 与 CPU 服务器上。框架内置 prefill/decode 分离、投机解码、零开销调度器与优化 GPU kernel 等特性,面向 从单 GPU 到分布式集群的大规模部署。官网展示 NVIDIA、xAI、Oracle、AMD、 LinkedIn、Google Cloud 等行业采用方;GitHub 36.8k star(2026-10-05), 最新版本 v0.5.21(2026-10-02)。
暂无相关文章。