开源多语语音识别模型,覆盖中粤英日韩五语、情感识别与音频事件检测
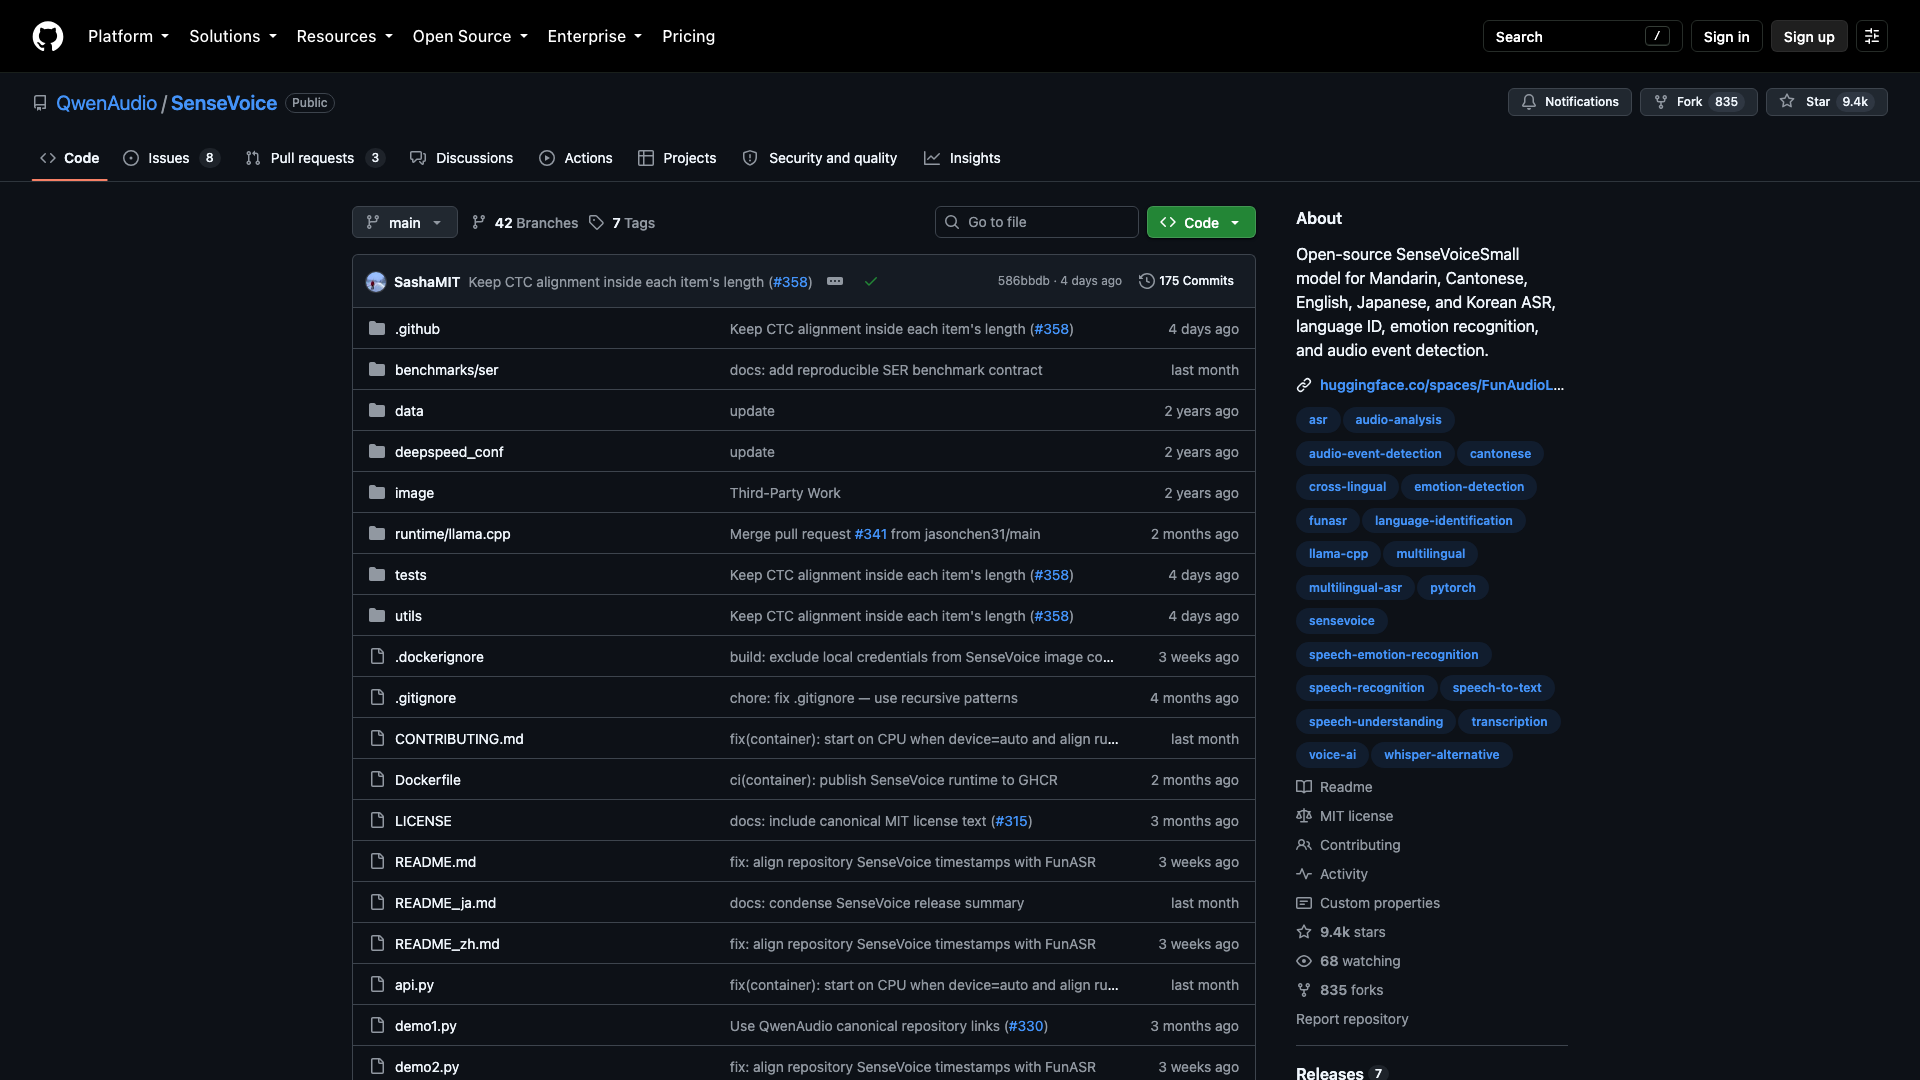
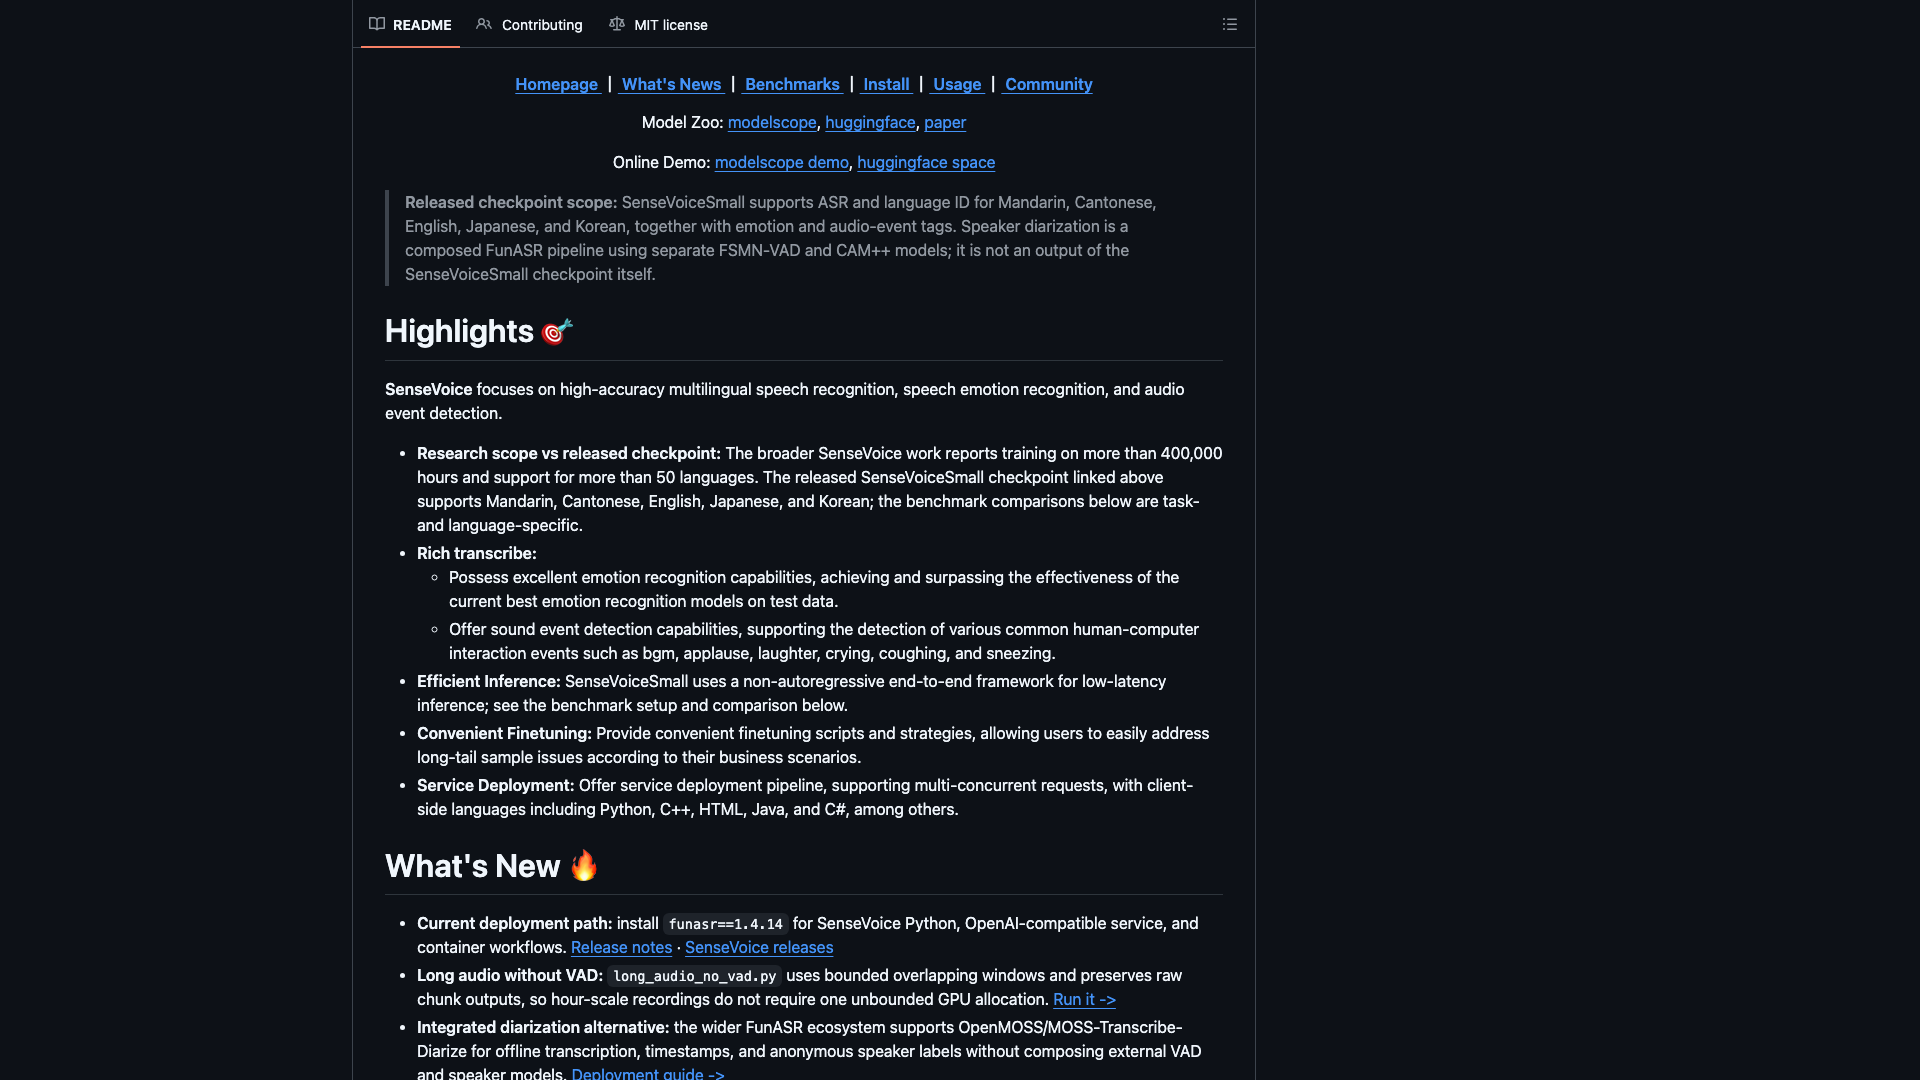
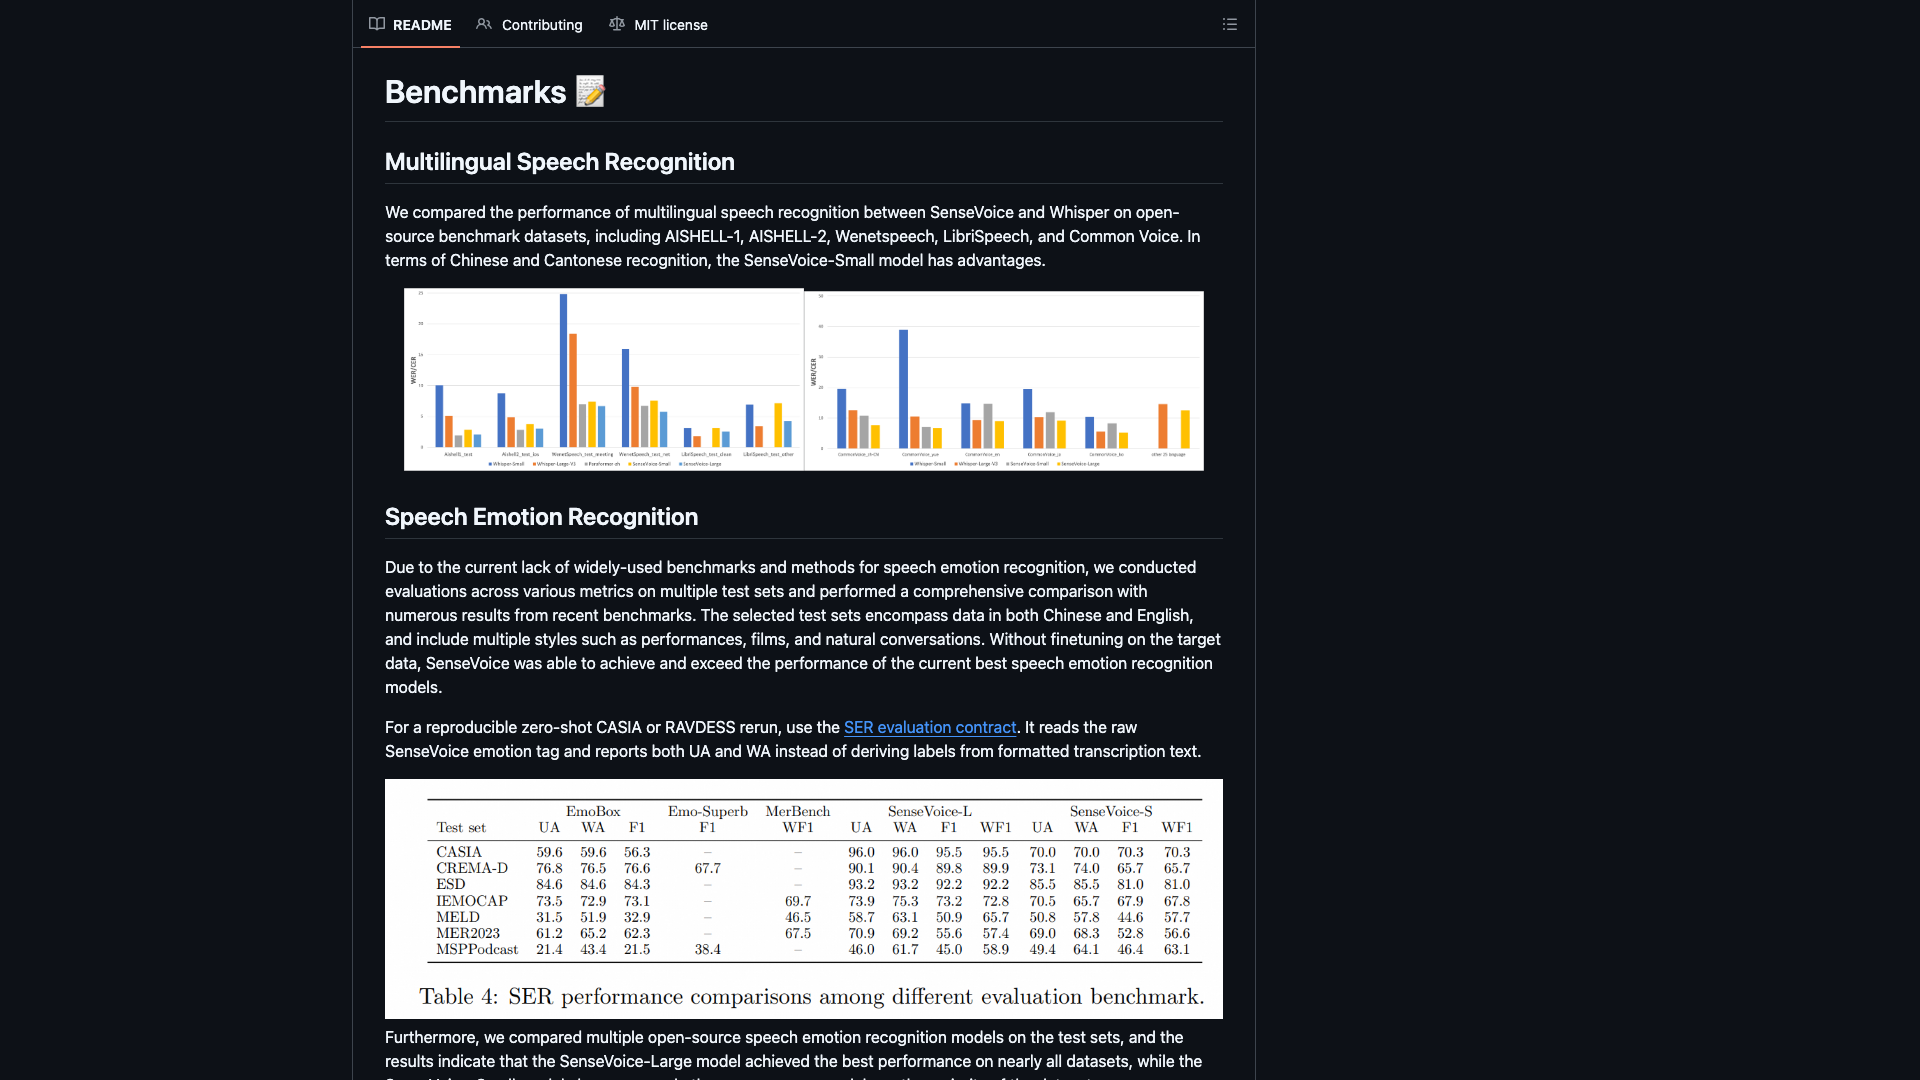
SenseVoice 是 QwenAudio org 下的开源语音基础模型,MIT 许可, GitHub 9.4k stars(2026-10-05)。发布 checkpoint SenseVoiceSmall 覆盖普通话、粤语、英语、日语、韩语的转写与语言识别,富转写同时 输出情感标签与 bgm、掌声、笑声、哭声、咳嗽、喷嚏等音频事件标签。 官方基准与 Whisper 在 AISHELL-1、AISHELL-2、Wenetspeech、 LibriSpeech、Common Voice 上对比,SenseVoice-Small 在中文与粤语 识别上有优势;非自回归端到端架构低延迟推理,提供微调脚本与 服务化部署,客户端含 Python、C++、Java、C# 等。funasr>=1.4.14 提供 OpenAI 兼容服务与容器工作流,long_audio_no_vad.py 用有界 重叠窗口处理小时级长录音;说话人分离需在 FunASR 管线组合 FSMN-VAD 与 CAM++,不是 checkpoint 自带输出。仓库现挂 QwenAudio org,在线 demo Space 仍在 FunAudioLLM 名下。
暂无相关文章。