开源 Python 自适应网页采集框架,网站改版后解析器自动重定位元素
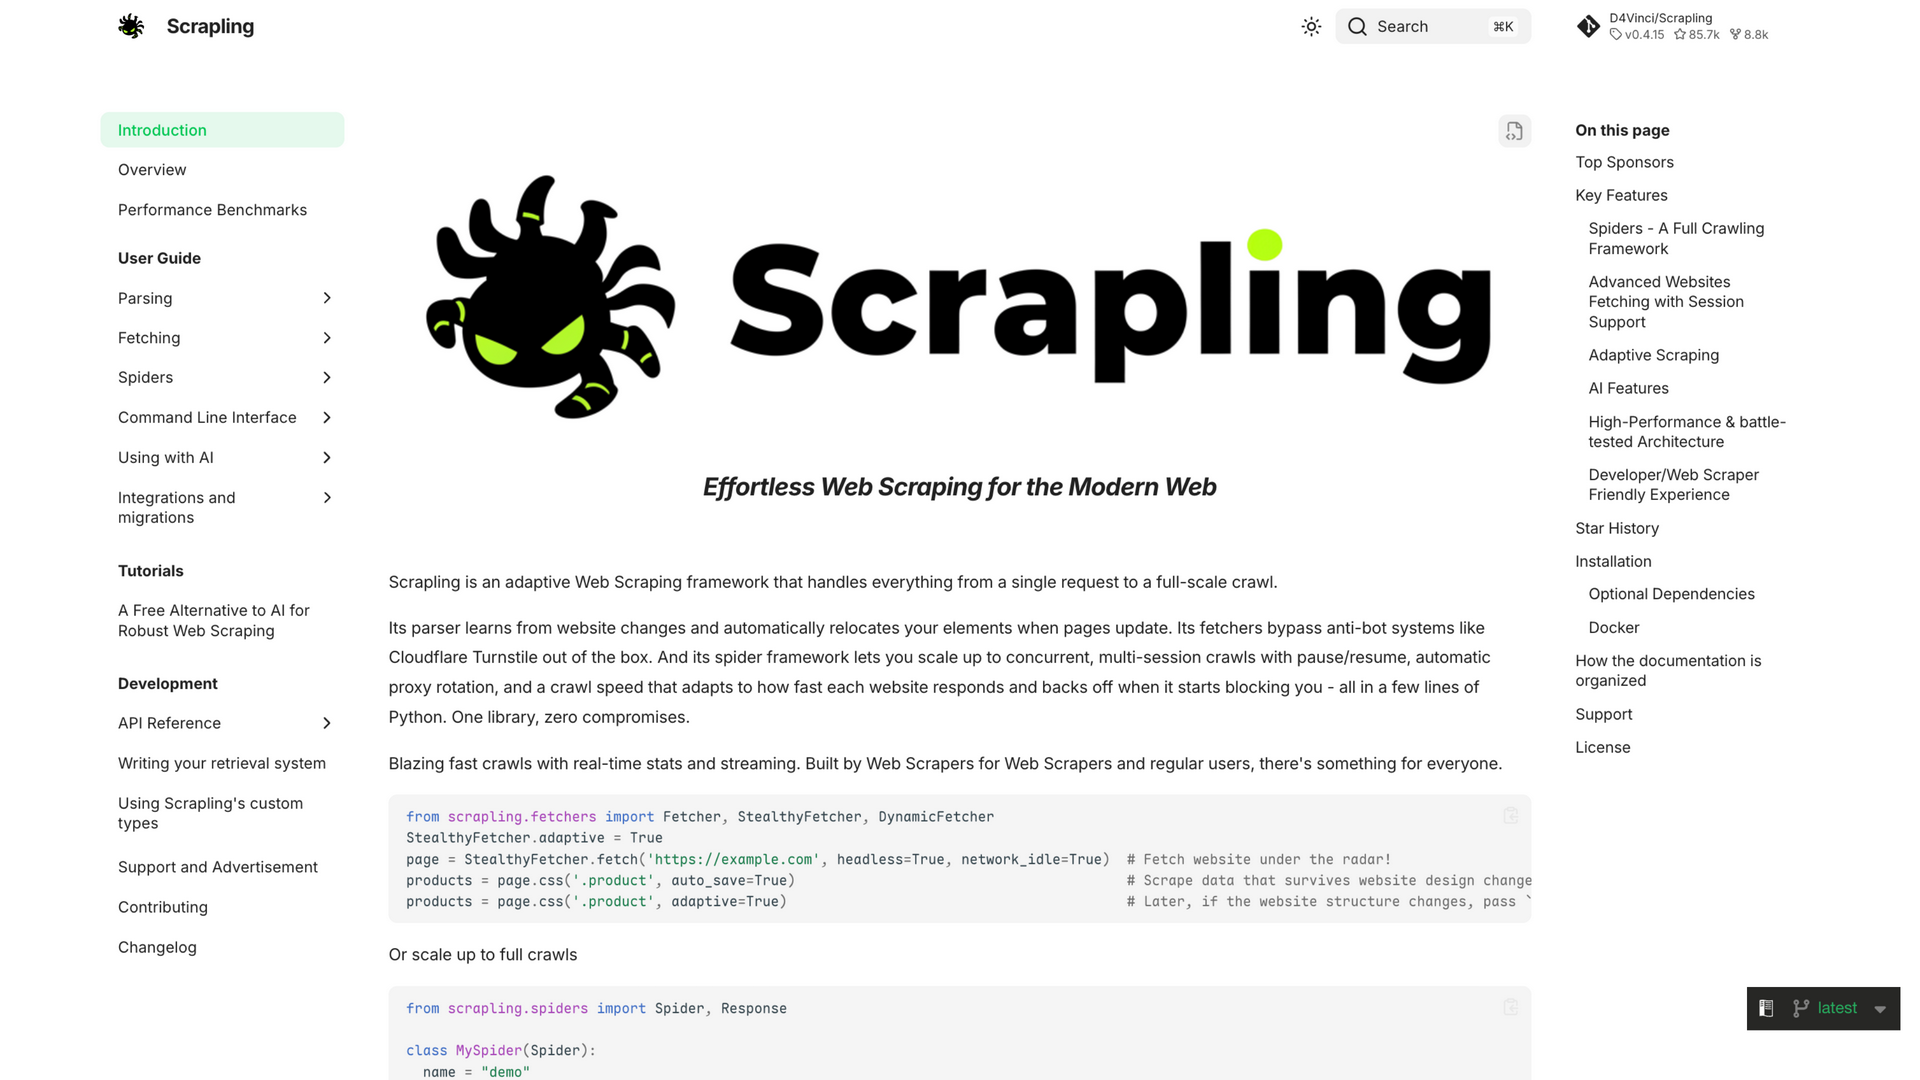
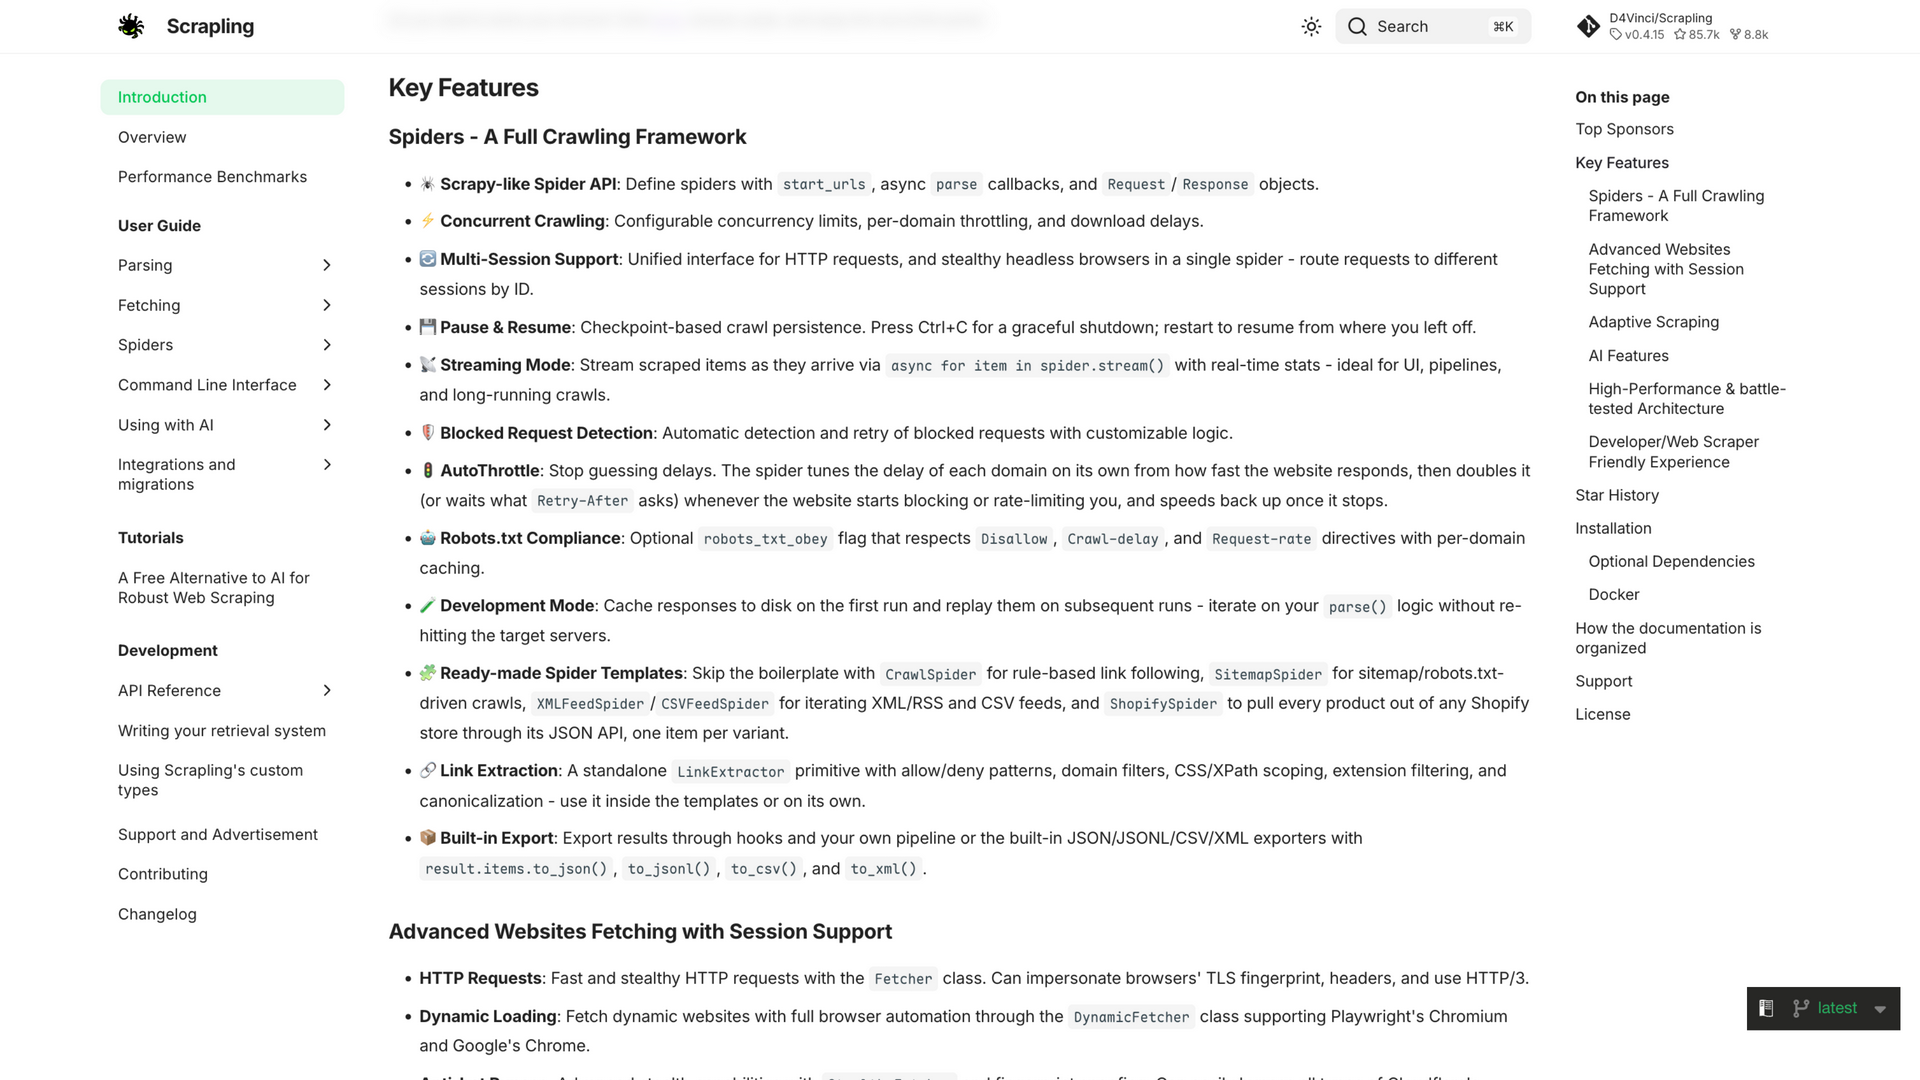
Scrapling 是 D4Vinci 开源的 Python 网页采集框架(GitHub ★85.7k,2026-10-05), 官方定位 "an adaptive Web Scraping framework that handles everything from a single request to a full-scale crawl"。解析器会学习网站变化,页面改版后自动重定位元素; Fetcher 可模拟浏览器 TLS 指纹并走 HTTP/3,开箱即用绕过 Cloudflare Turnstile 等反爬系统。 Spiders 子框架提供类 Scrapy 的爬虫 API,支持并发、断点续爬与自适应限速;另内置 MCP Server 供 Claude/Cursor 等 agent 调用,page.markdown() 一行把页面转成干净 Markdown。 开源免费,pip 即装,另有交互式 shell 与终端命令,不写代码也能抓取。
暂无相关文章。