腾讯音乐 Lyra Lab 开源的实时音频驱动唇形同步模型,V100 推理 30fps+
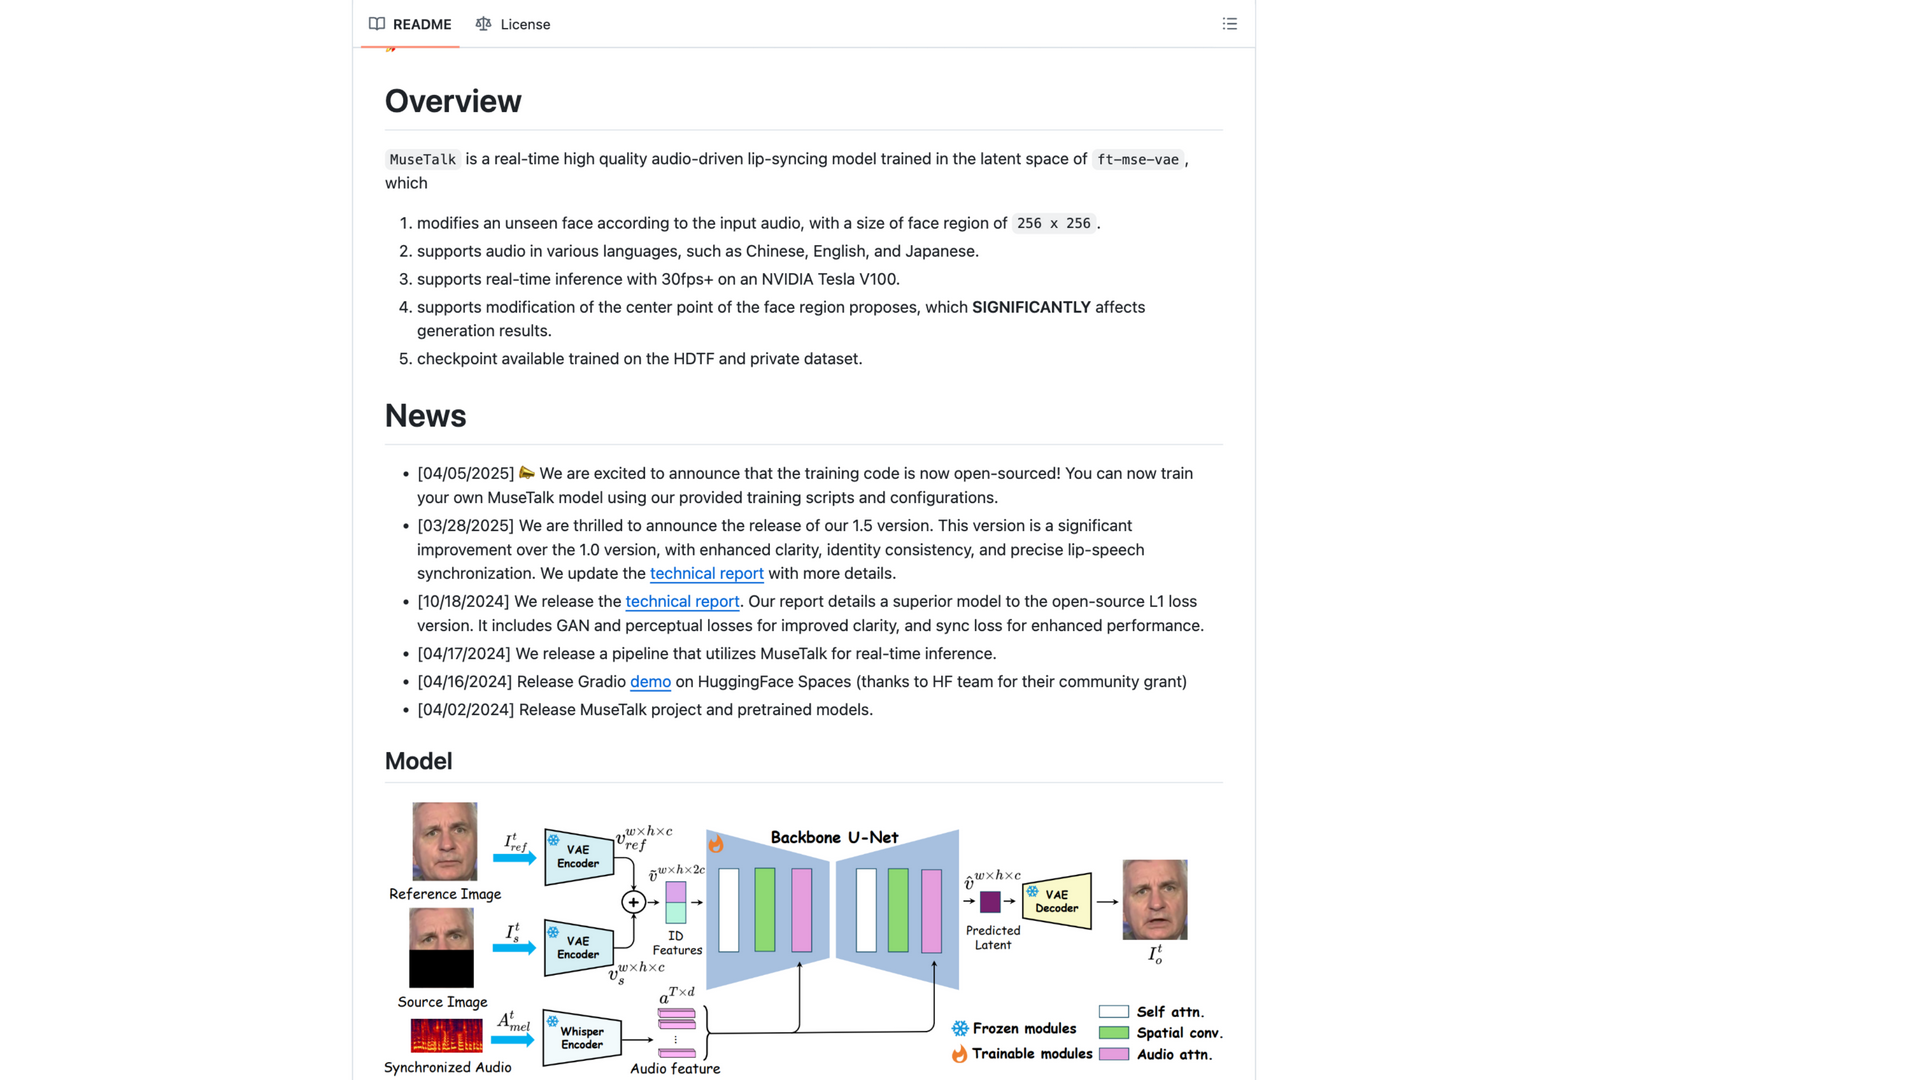
MuseTalk 是腾讯音乐 Lyra Lab(TMElyralab)开源的实时唇形同步模型:在 ft-mse-vae 潜空间以单步 inpainting 修改未见人脸的口型区域(256×256),音频由 whisper-tiny 编码融合,官方强调它并非扩散模型。支持中、英、日音频输入,NVIDIA Tesla V100 上实时推理 30fps+,可接 MuseV 生成的视频组成完整数字人方案。MuseTalk 1.5 引入感知损失、GAN 损失与 sync loss 及两阶段训练策略,官方称清晰度、身份一致性 与唇音同步精度显著提升,推理、训练代码与权重均已开源,代码 MIT 许可、模型可商用。 另有 HuggingFace Spaces Gradio demo 与 ComfyUI 第三方集成(官方未验证维护); GitHub 6.7k stars(2026-10-06),主分支最后提交 2025-09-26,已约一年无更新。
暂无相关文章。