LLM 应用的上下文优化层,工具输出与 RAG 结果到达模型前先压缩
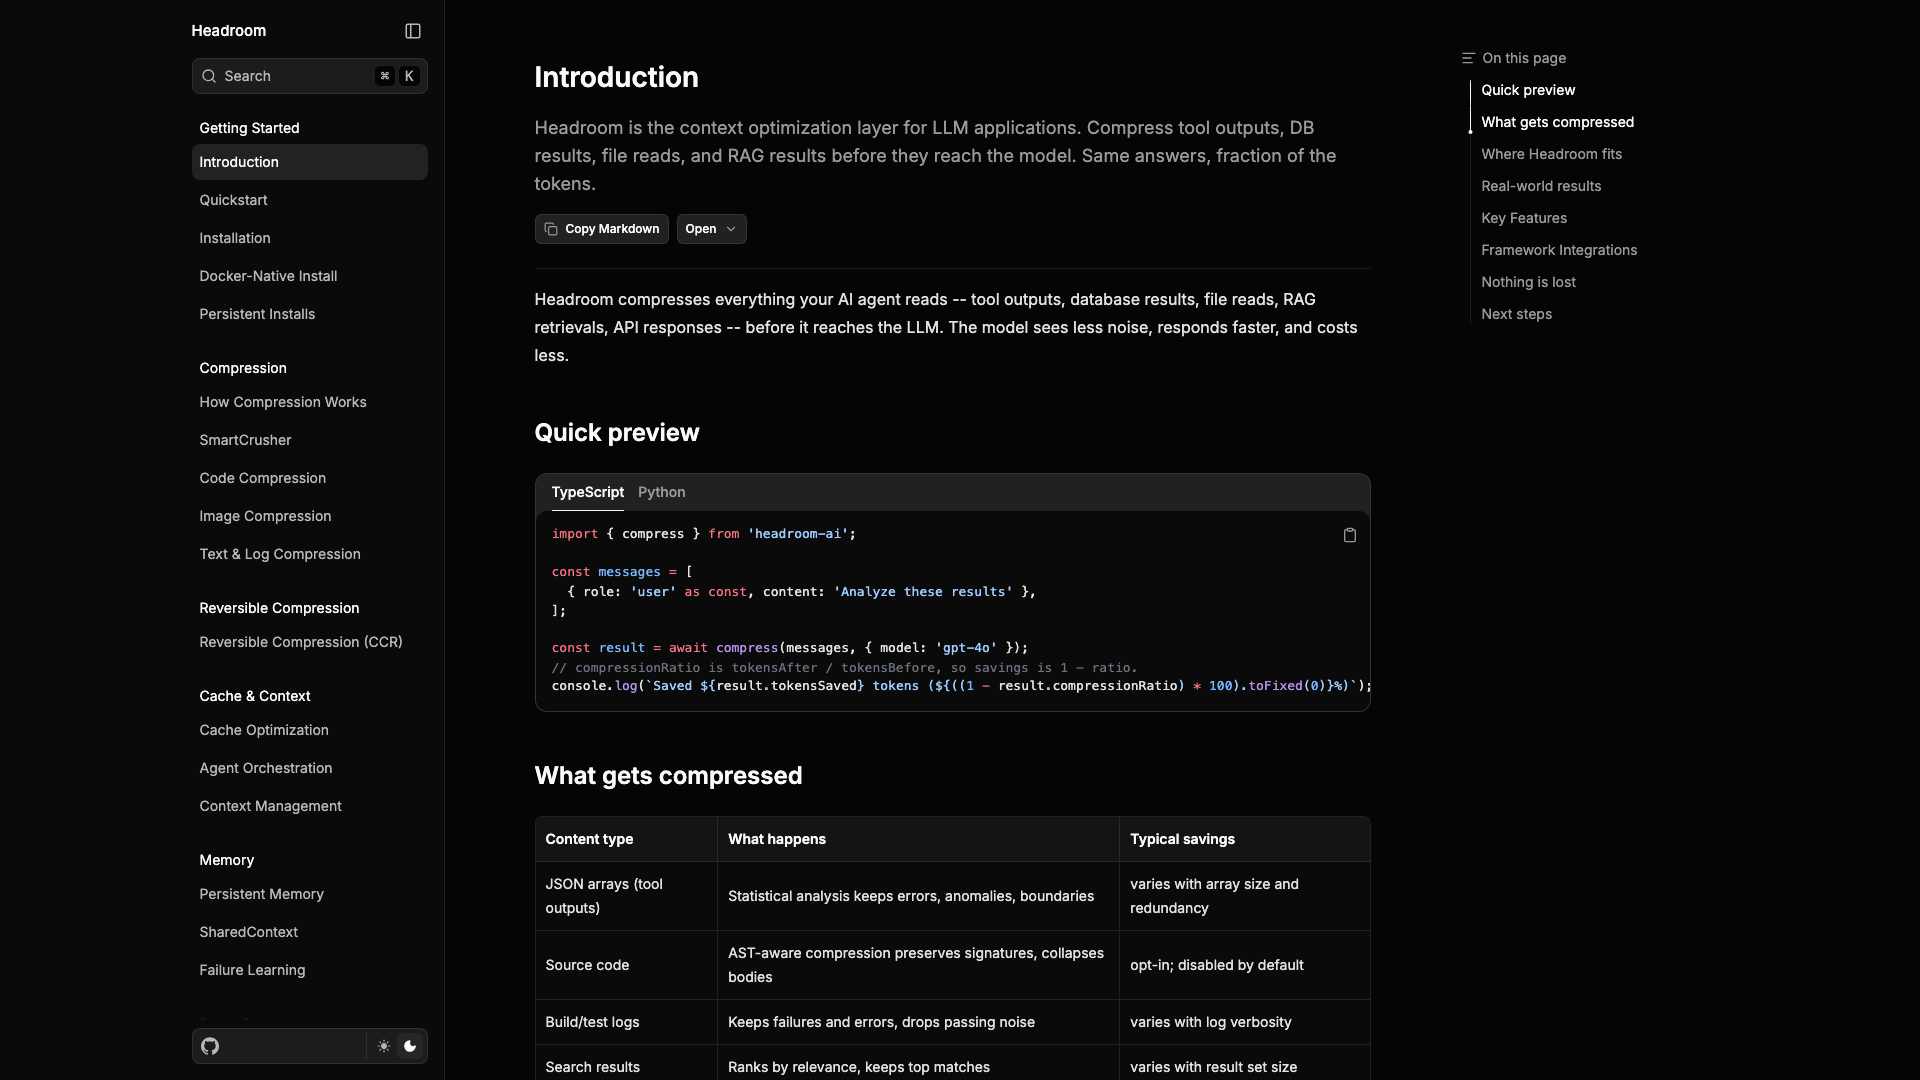
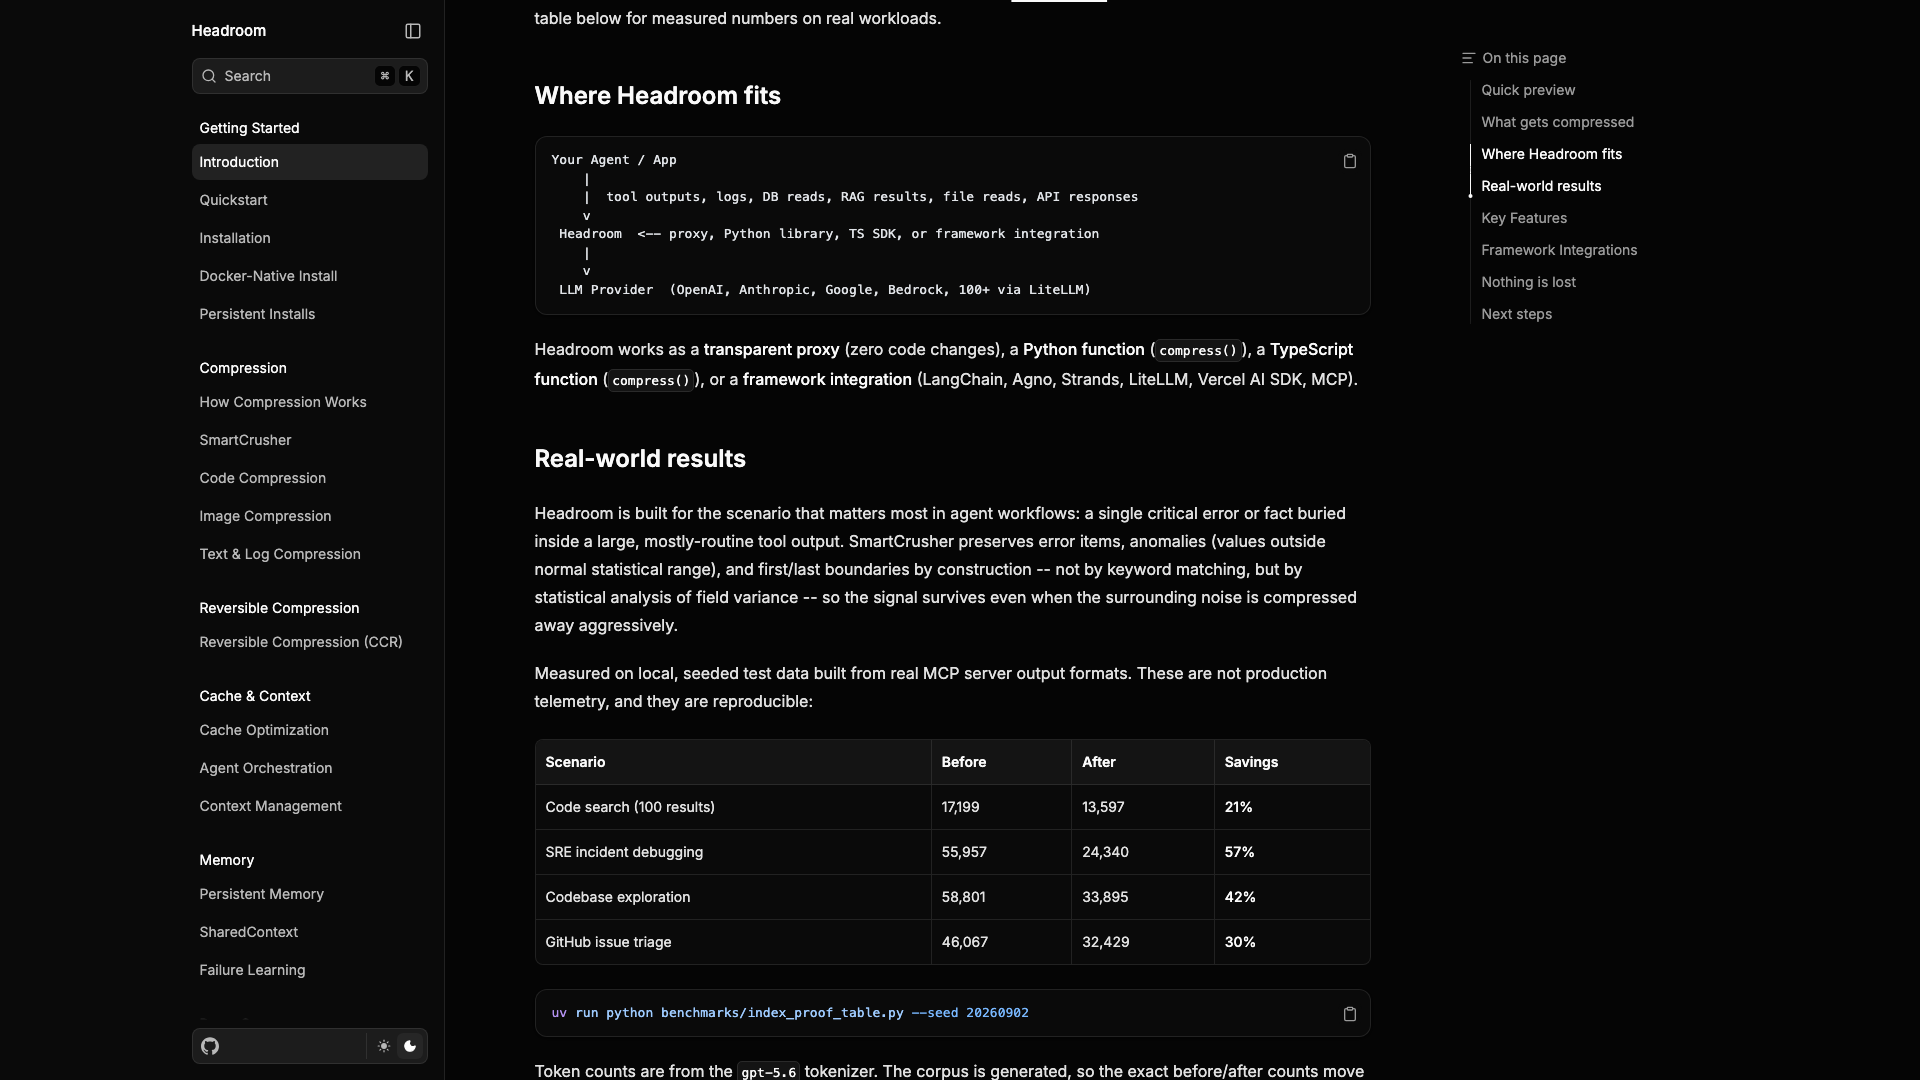
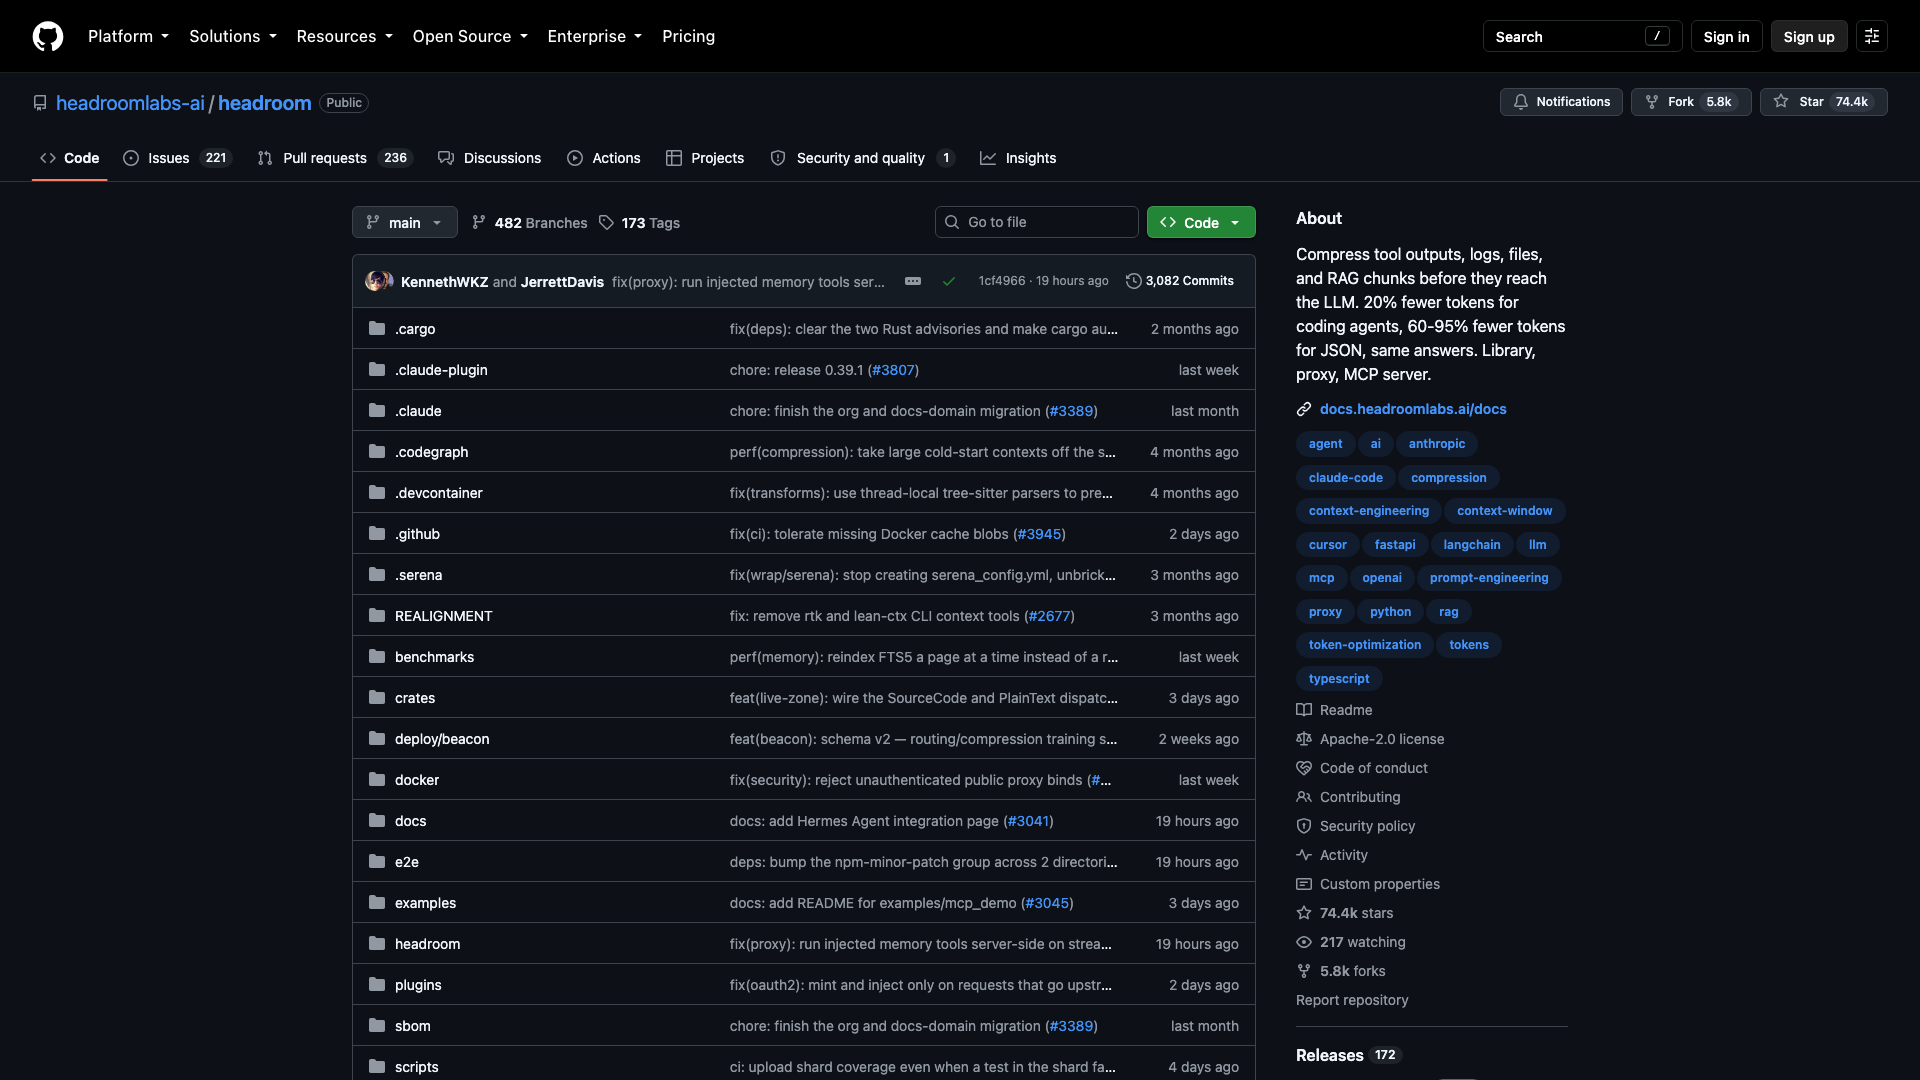
Apache-2.0 开源项目,在工具输出、DB 结果、文件读取与 RAG 块 到达模型前先行压缩,官方称编码 Agent 省 20% token、JSON 省 60-95%,"same answers"。以 Python 或 TypeScript 函数、透明代理(零 代码改动)与 MCP server 三种形态接入,可集成 LangChain、LiteLLM、 Vercel AI SDK 等框架,下游对接 "OpenAI, Anthropic, Google, Bedrock, 100+ via LiteLLM"。官方基于可复现的种子测试数据实测代码搜索、SRE 事件调试等四类任务 token 节省 21%-57%,并公开带 seed 的复现命令。 GitHub 74.4k stars、172 个 Releases(2026-10-05),核心以 Rust 编写。
暂无相关文章。