蚂蚁集团开源的 1.3B 统一多模态多任务人体动画模型,AAAI 2026 接收
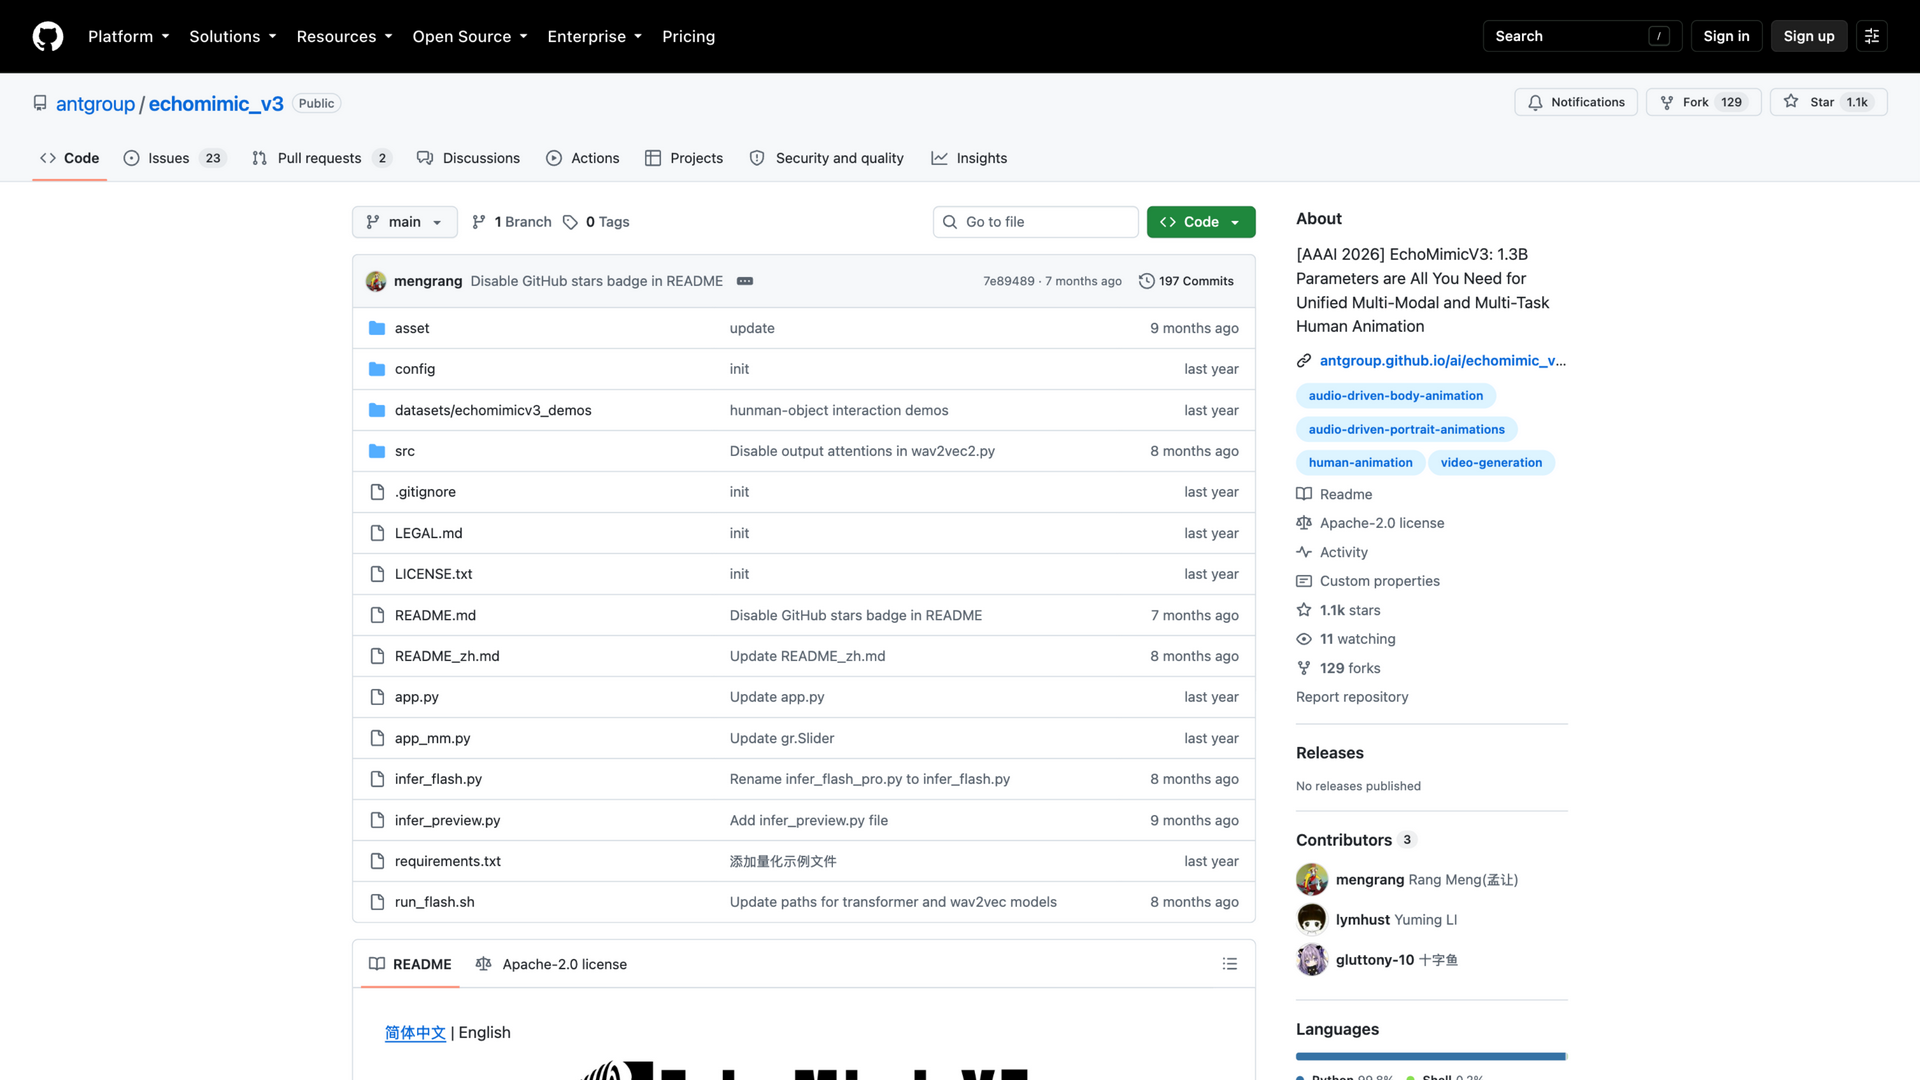
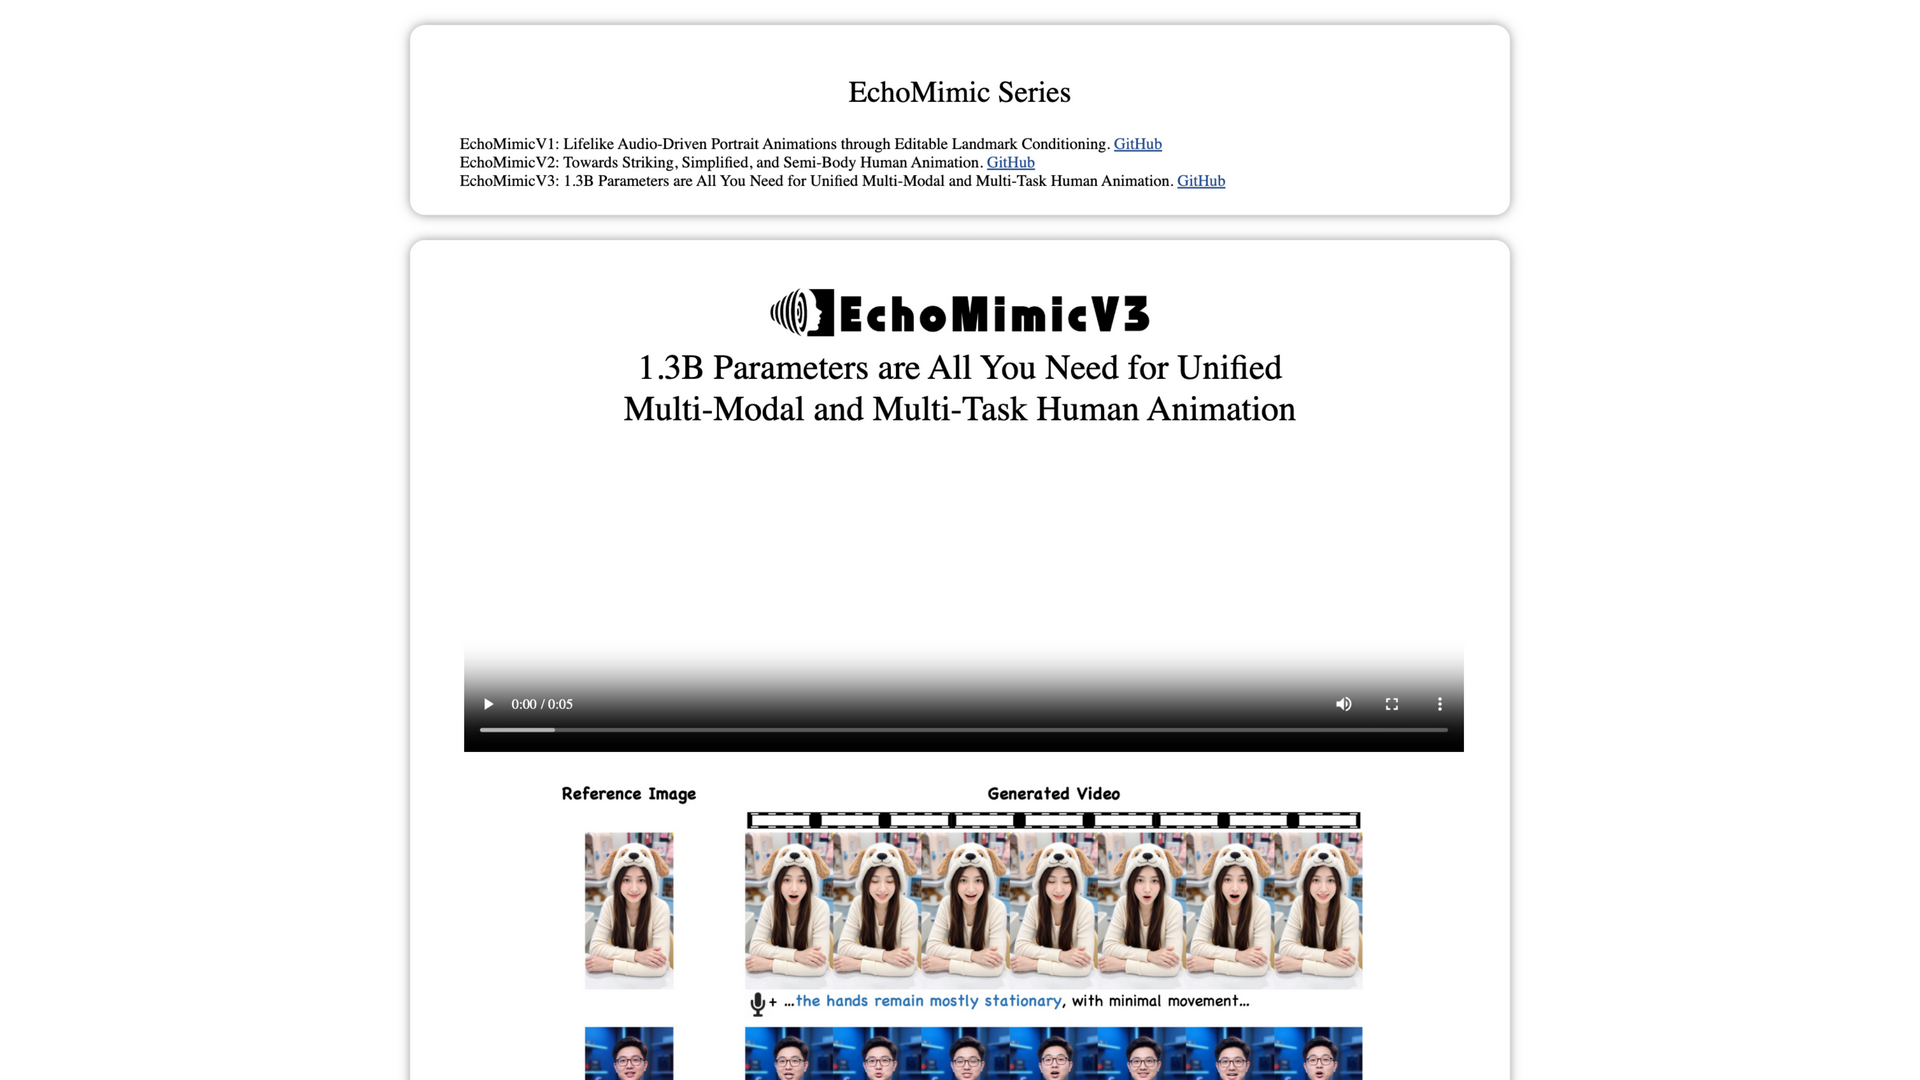
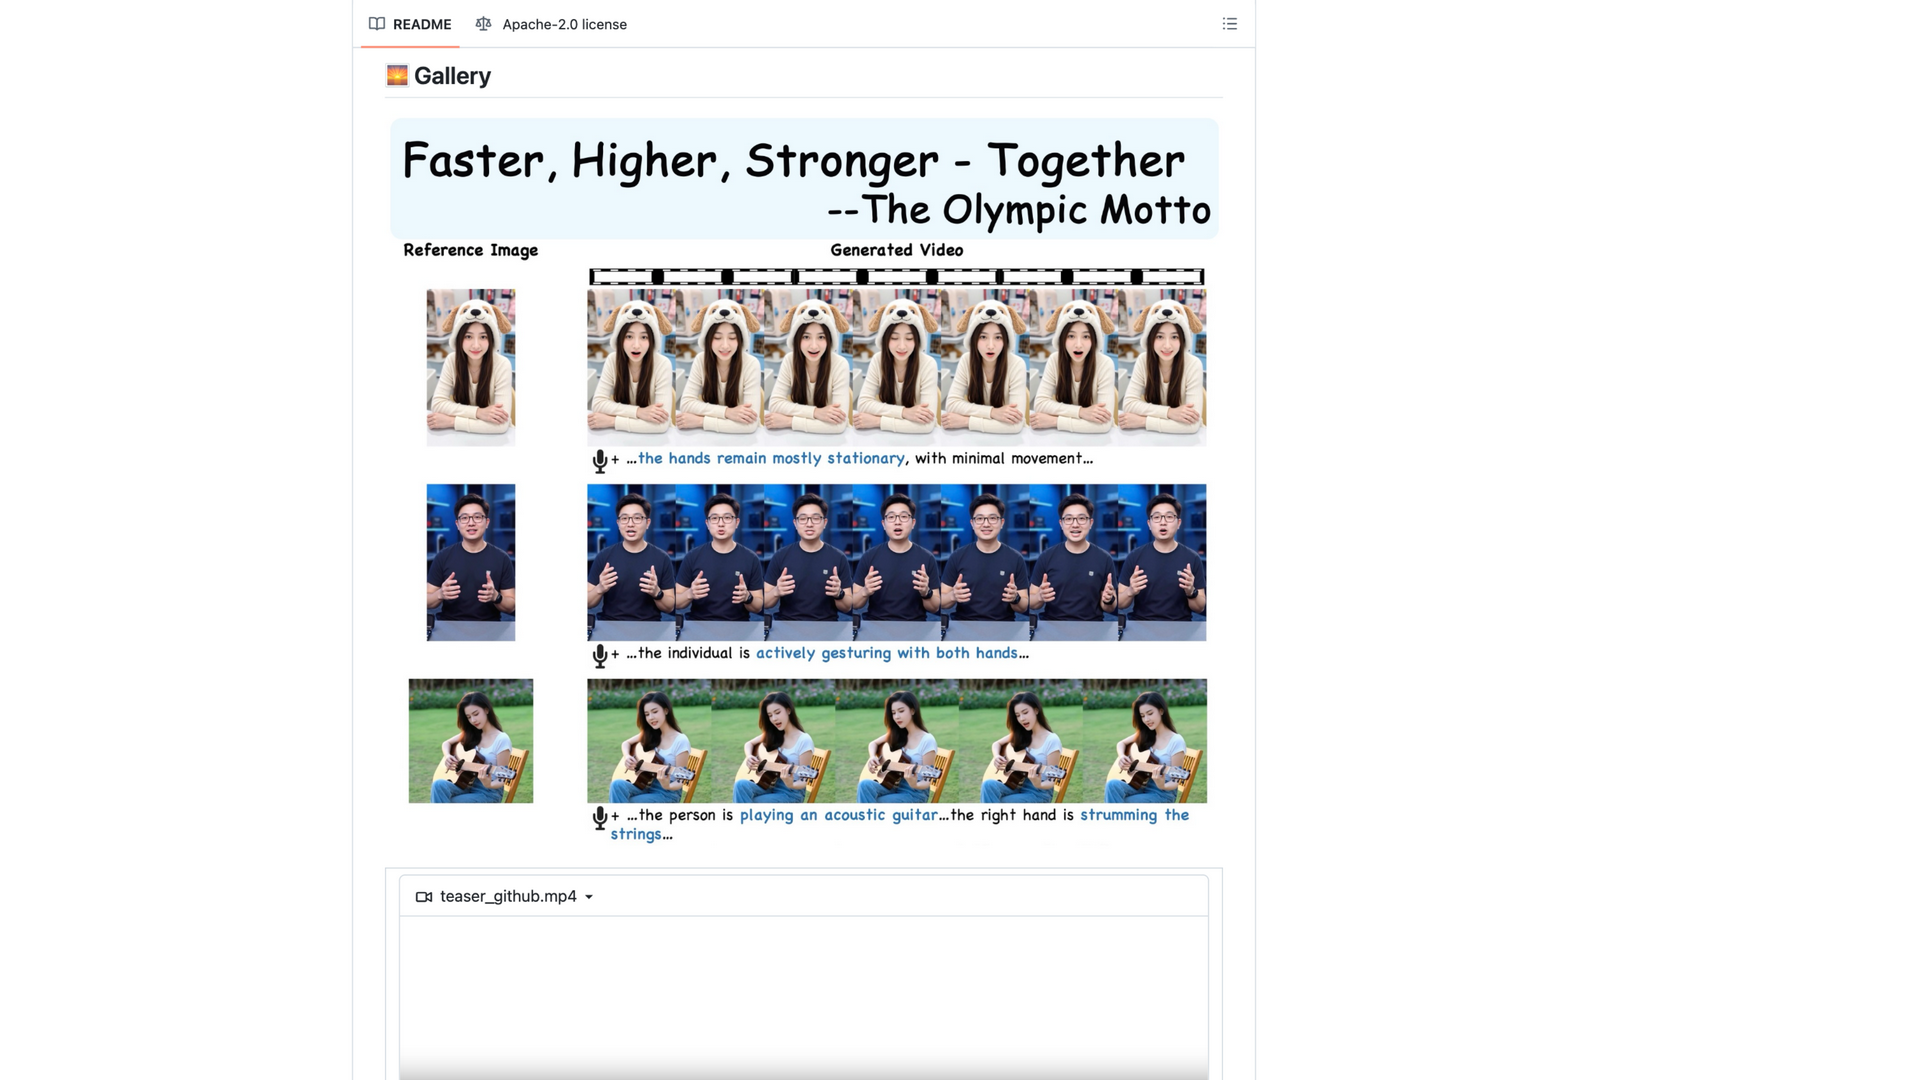
EchoMimicV3 是蚂蚁集团支付宝终端技术部团队开源的统一多模态多任务 人体动画模型(Apache-2.0,AAAI 2026 接收),以 1.3B 参数用音频、表情等 条件驱动肖像与人体动画生成视频,官方示例以参考图配语音指令演示奥运口号 横幅、双手姿势、弹吉他三组动作。2026 年 1 月更新的 EchoMimicV3-Flash 支持无需面部遮罩的 8 步生成,显存要求 12G、分辨率至 768×768,另有 16G 显存可跑的第三方 ComfyUI 集成。权重经 HuggingFace 与 ModelScope 分发, 提供 ModelScope Gradio demo、中文 README 与中文常见问题汇总,面向人体 动画与数字人视频生成的开发者、研究者。系列前作 V1 主打音频驱动肖像动画、 V2 主打半身人体动画,本仓 V3 为统一版本;GitHub 1.1k stars(2026-10-06), 主分支最后提交 2026-03-18。
暂无相关文章。