开源多语言 TTS 大模型,覆盖 9 种语言与 18+ 种中文方言,流式延迟低至 150ms
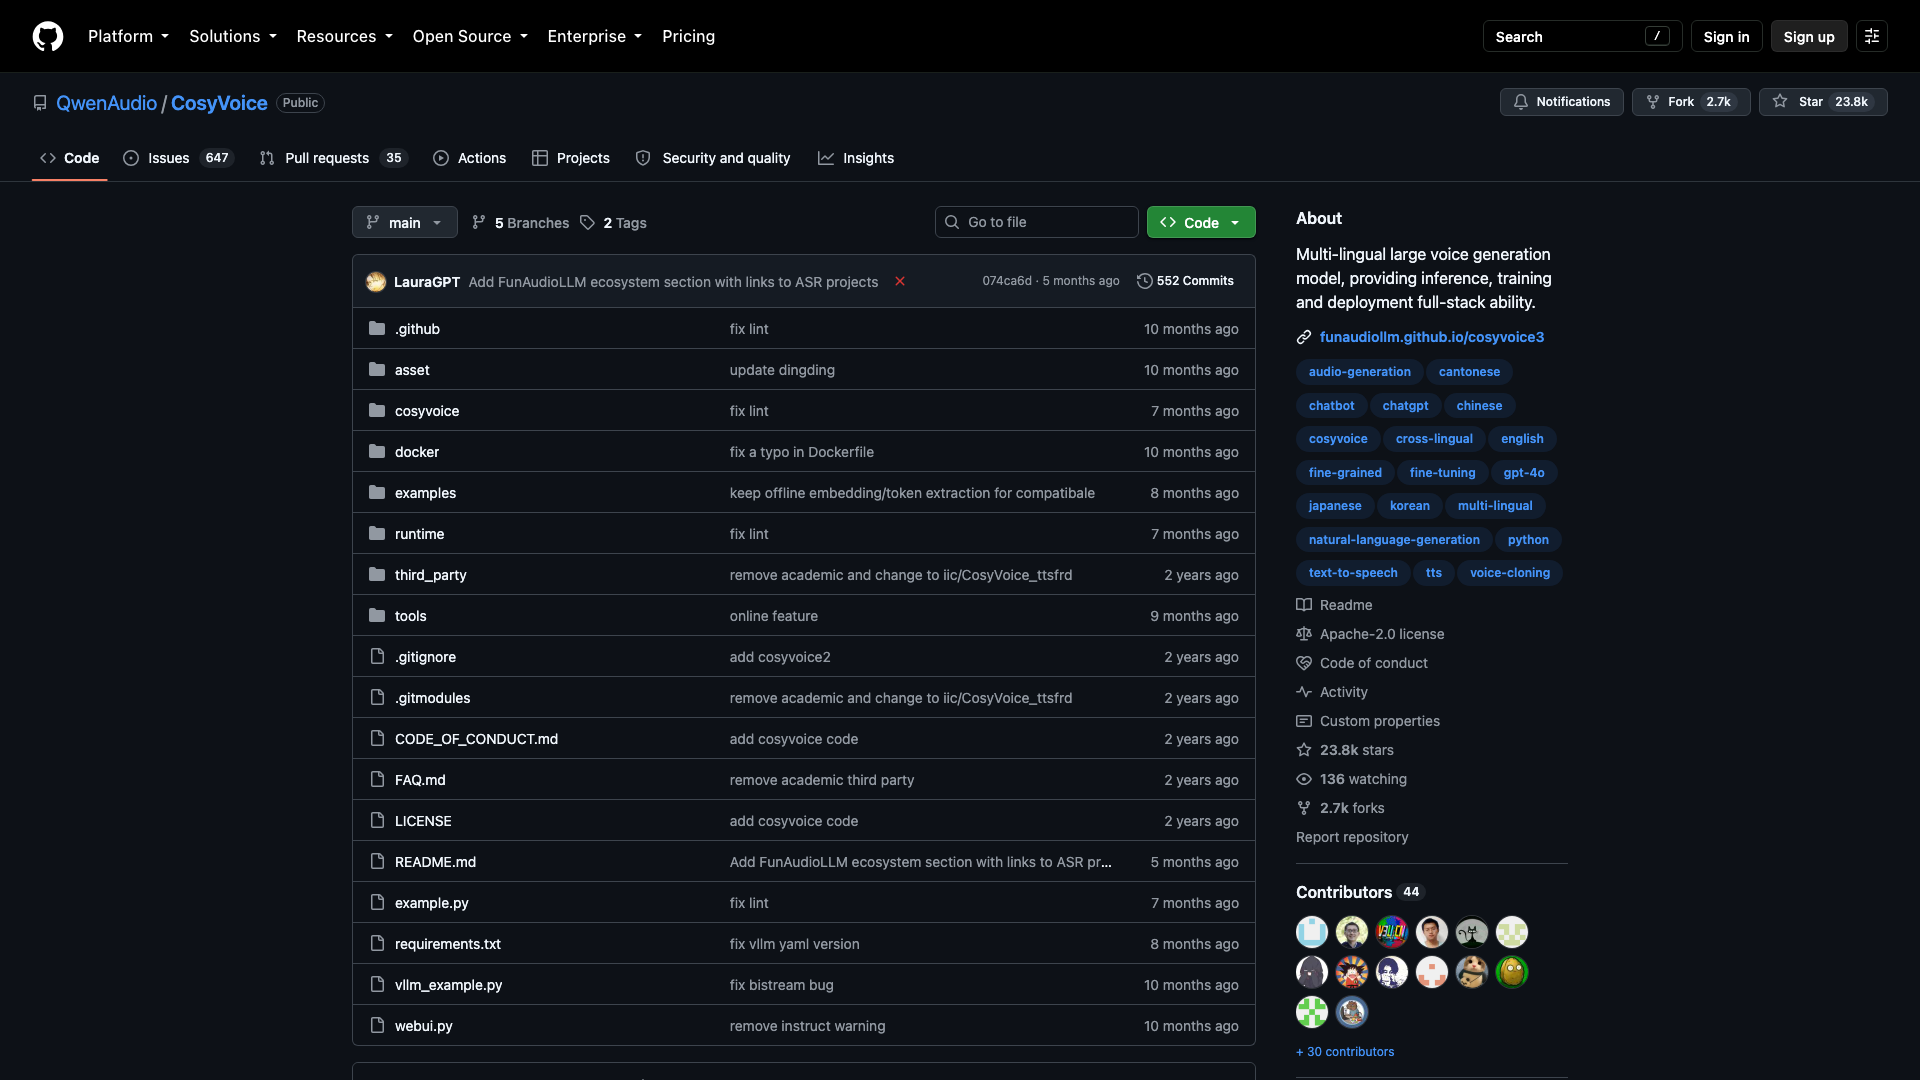
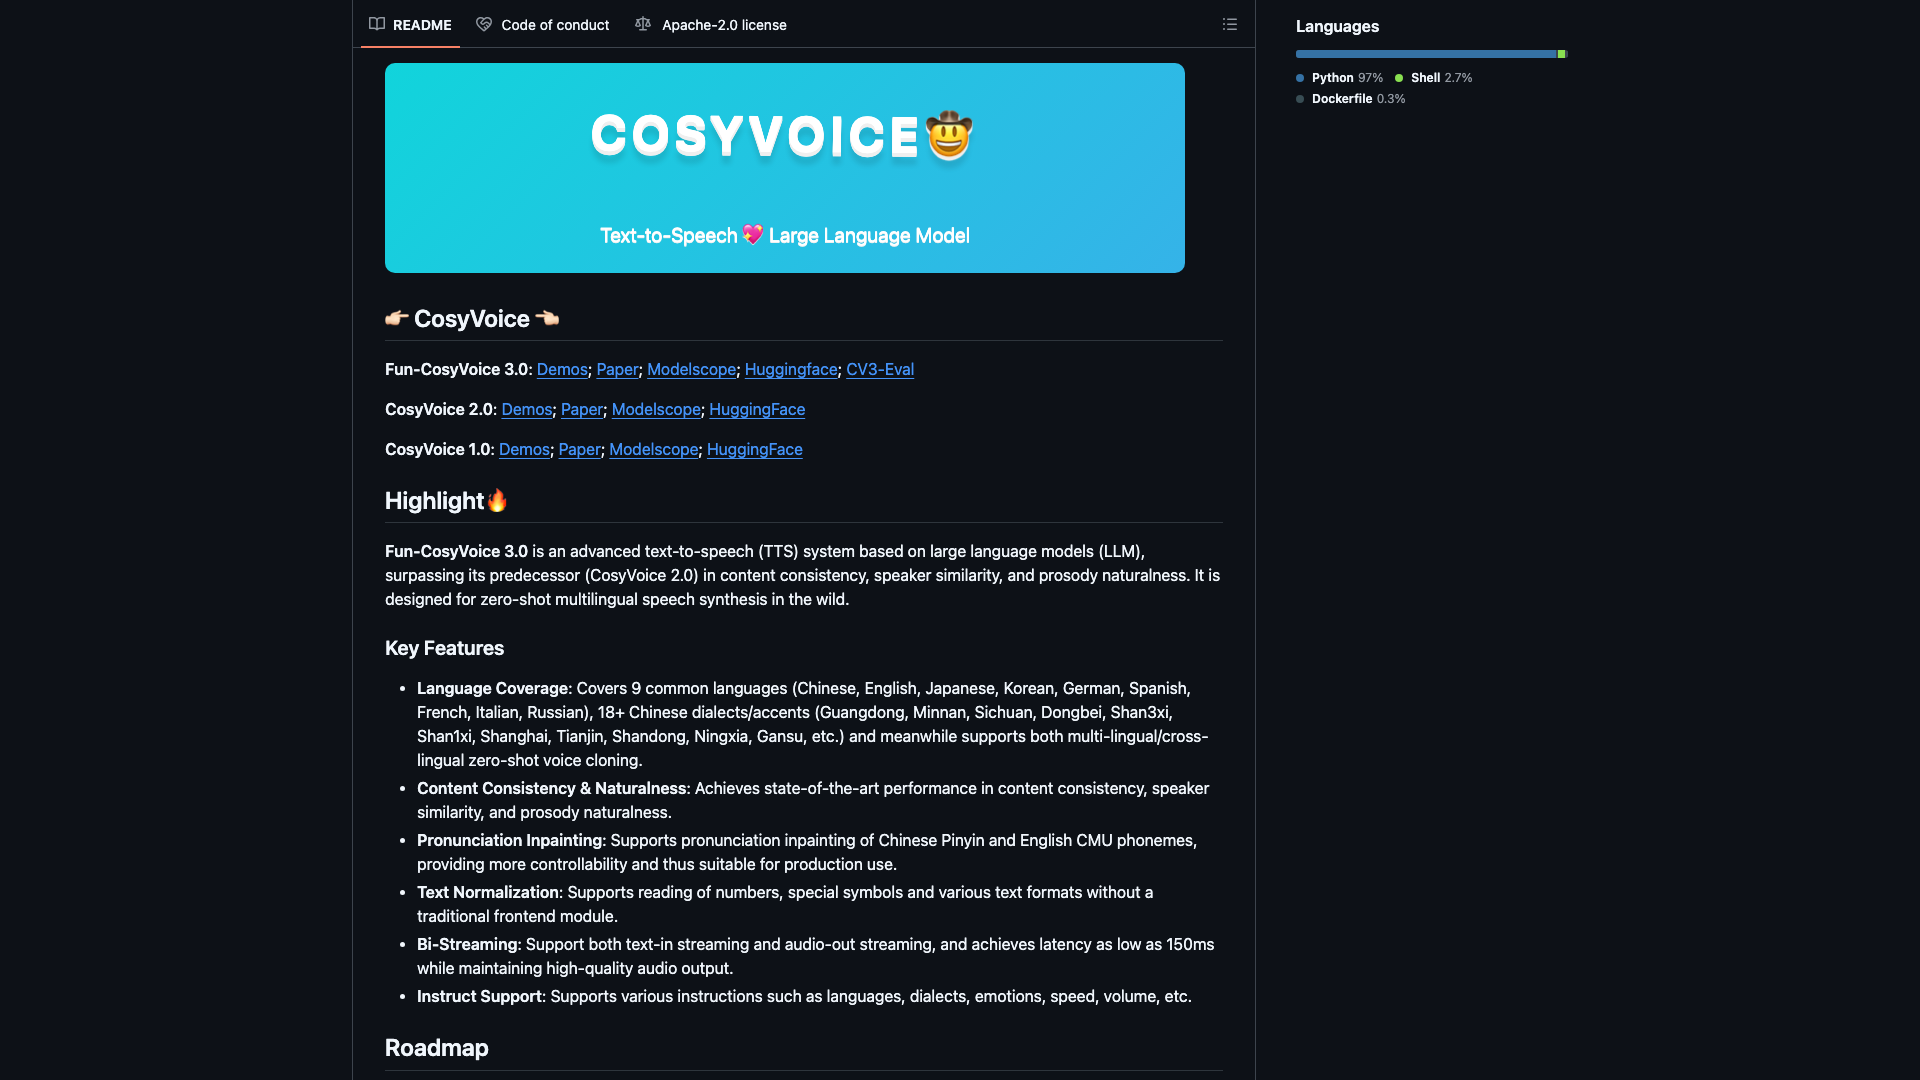
CosyVoice 是多语言大规模语音生成模型(TTS × LLM),Apache-2.0 开源, 提供推理、训练与部署全栈能力,最新一代 Fun-CosyVoice 3.0 官方称在内容一致性、 说话人相似度与韵律自然度上超越上一代。覆盖中、英、日、韩等 9 种语言与 18+ 种中国方言口音,支持多语言、跨语言零样本声音克隆。支持中文拼音与 英文 CMU 音素的发音修复,数字、特殊符号等文本无需传统前端模块即可朗读; 语言、方言、情感、语速、音量均可用指令控制。支持文本流式输入与音频流式 输出双向流式,延迟低至 150ms;仓库已由 FunAudioLLM 迁移至 QwenAudio org。
暂无相关文章。